


图片:METAL
摘要
- 谷歌研究院于10月2日发布基于TEE的联邦学习系统,借助可信执行环境(TEE)和公开透明日志,使服务器端处理可接受外部验证。
- 允许处理数据的代码在设备上传之前就已公布在Rekor透明日志中,相关二进制文件可依据GitHub上的开源代码重新构建并比对。
- 在Gboard的A/B测试中,用新系统训练的英语模型以比现有生产模型小三倍的隐私预算取得了相同的可用性指标,训练时间从两个月缩短至三周。
谷歌研究院于当地时间10月2日发布了一套基于TEE的联邦学习系统,在服务器端汇集设备数据进行训练的同时,让外部可以验证数据的处理过程。数据只在可信执行环境(TEE)即服务器芯片内部的隔离区域中解密,哪些代码可以接触这些数据,则事先公布在公开透明日志中。谷歌已用该系统推出了安卓键盘Gboard的英语和日语下一词预测模型。据同时发布的白皮书,在实际A/B测试中,用新系统训练的英语模型所用隐私预算比现有生产模型小三倍,打字速度等关键可用性指标保持不变,训练时间从两个月缩短到三周。
联邦学习是一种不把数据集中到一处、由众多设备共同训练模型的技术。谷歌此前已将其用于Gboard的下一词预测和智能撰写、Google Messages的回复建议以及安卓的智能文本选择。症结在于服务器。谷歌在博客中解释,在早期系统中,设备和审计方都无法验证服务器上运行的逻辑,因此用户只能相信谷歌会正确地向梯度和中添加随机噪声以实现差分隐私。后来引入的安全聚合(Secure Aggregation)以加密方式保护上传数据,但无法与最先进的中心化差分隐私保证兼容。
撰写博客的谷歌研究院软件工程师凯瑟琳·戴利和研究总监丹尼尔·拉米奇表示:"新的基于TEE的系统是我们为彻底消除信任服务器运营方之必要而持续努力的下一个里程碑。"白皮书称,该系统首次提供了可外部验证的中心化差分隐私保证。TEE在单台机器层面提供远程证明(第三方可确认正在运行的逻辑)、机密性(内部状态无法被观察)和完整性(逻辑无法被干扰),谷歌将这些特性串联起来,构建了端到端可验证的联邦学习系统。服务器端TEE采用了AMD SEV-SNP和英特尔TDX。
其运作流程如下。设备在上传前自行加密训练样本,并事先批准一份访问策略,即允许处理这些数据的TEE计算清单。只有当该访问策略已发布到公开透明日志Rekor中时,设备才会上传。掌管解密密钥的密钥管理系统(KMS)是一个通过RAFT共识协议组成的TEE集群,只向与访问策略中所列计算相符的服务器端TEE任务发放密钥。实际训练由执行Python训练循环的根TEE负责,可并行的工作则分派给工作TEE。分布式逻辑使用源自TensorFlow Federated的开源编排语言Federated Language编写。
据METAL查阅的14页白皮书,访问策略中同时嵌入了包含训练逻辑的Python程序本身以及根TEE和工作TEE二进制文件的哈希值。访问策略一旦发布到透明日志,该Python程序即成为开源代码,外部审计方可以直接阅读程序如何确立差分隐私。KMS和数据处理二进制文件可依据GitHub上Confidential Federated Compute仓库公开的代码进行可复现构建。审计方即使没有参与训练的设备,只看日志也能掌握服务器上可能运行的全部任务,而任务运营方能看到的只有指标和经过差分隐私处理的模型权重。
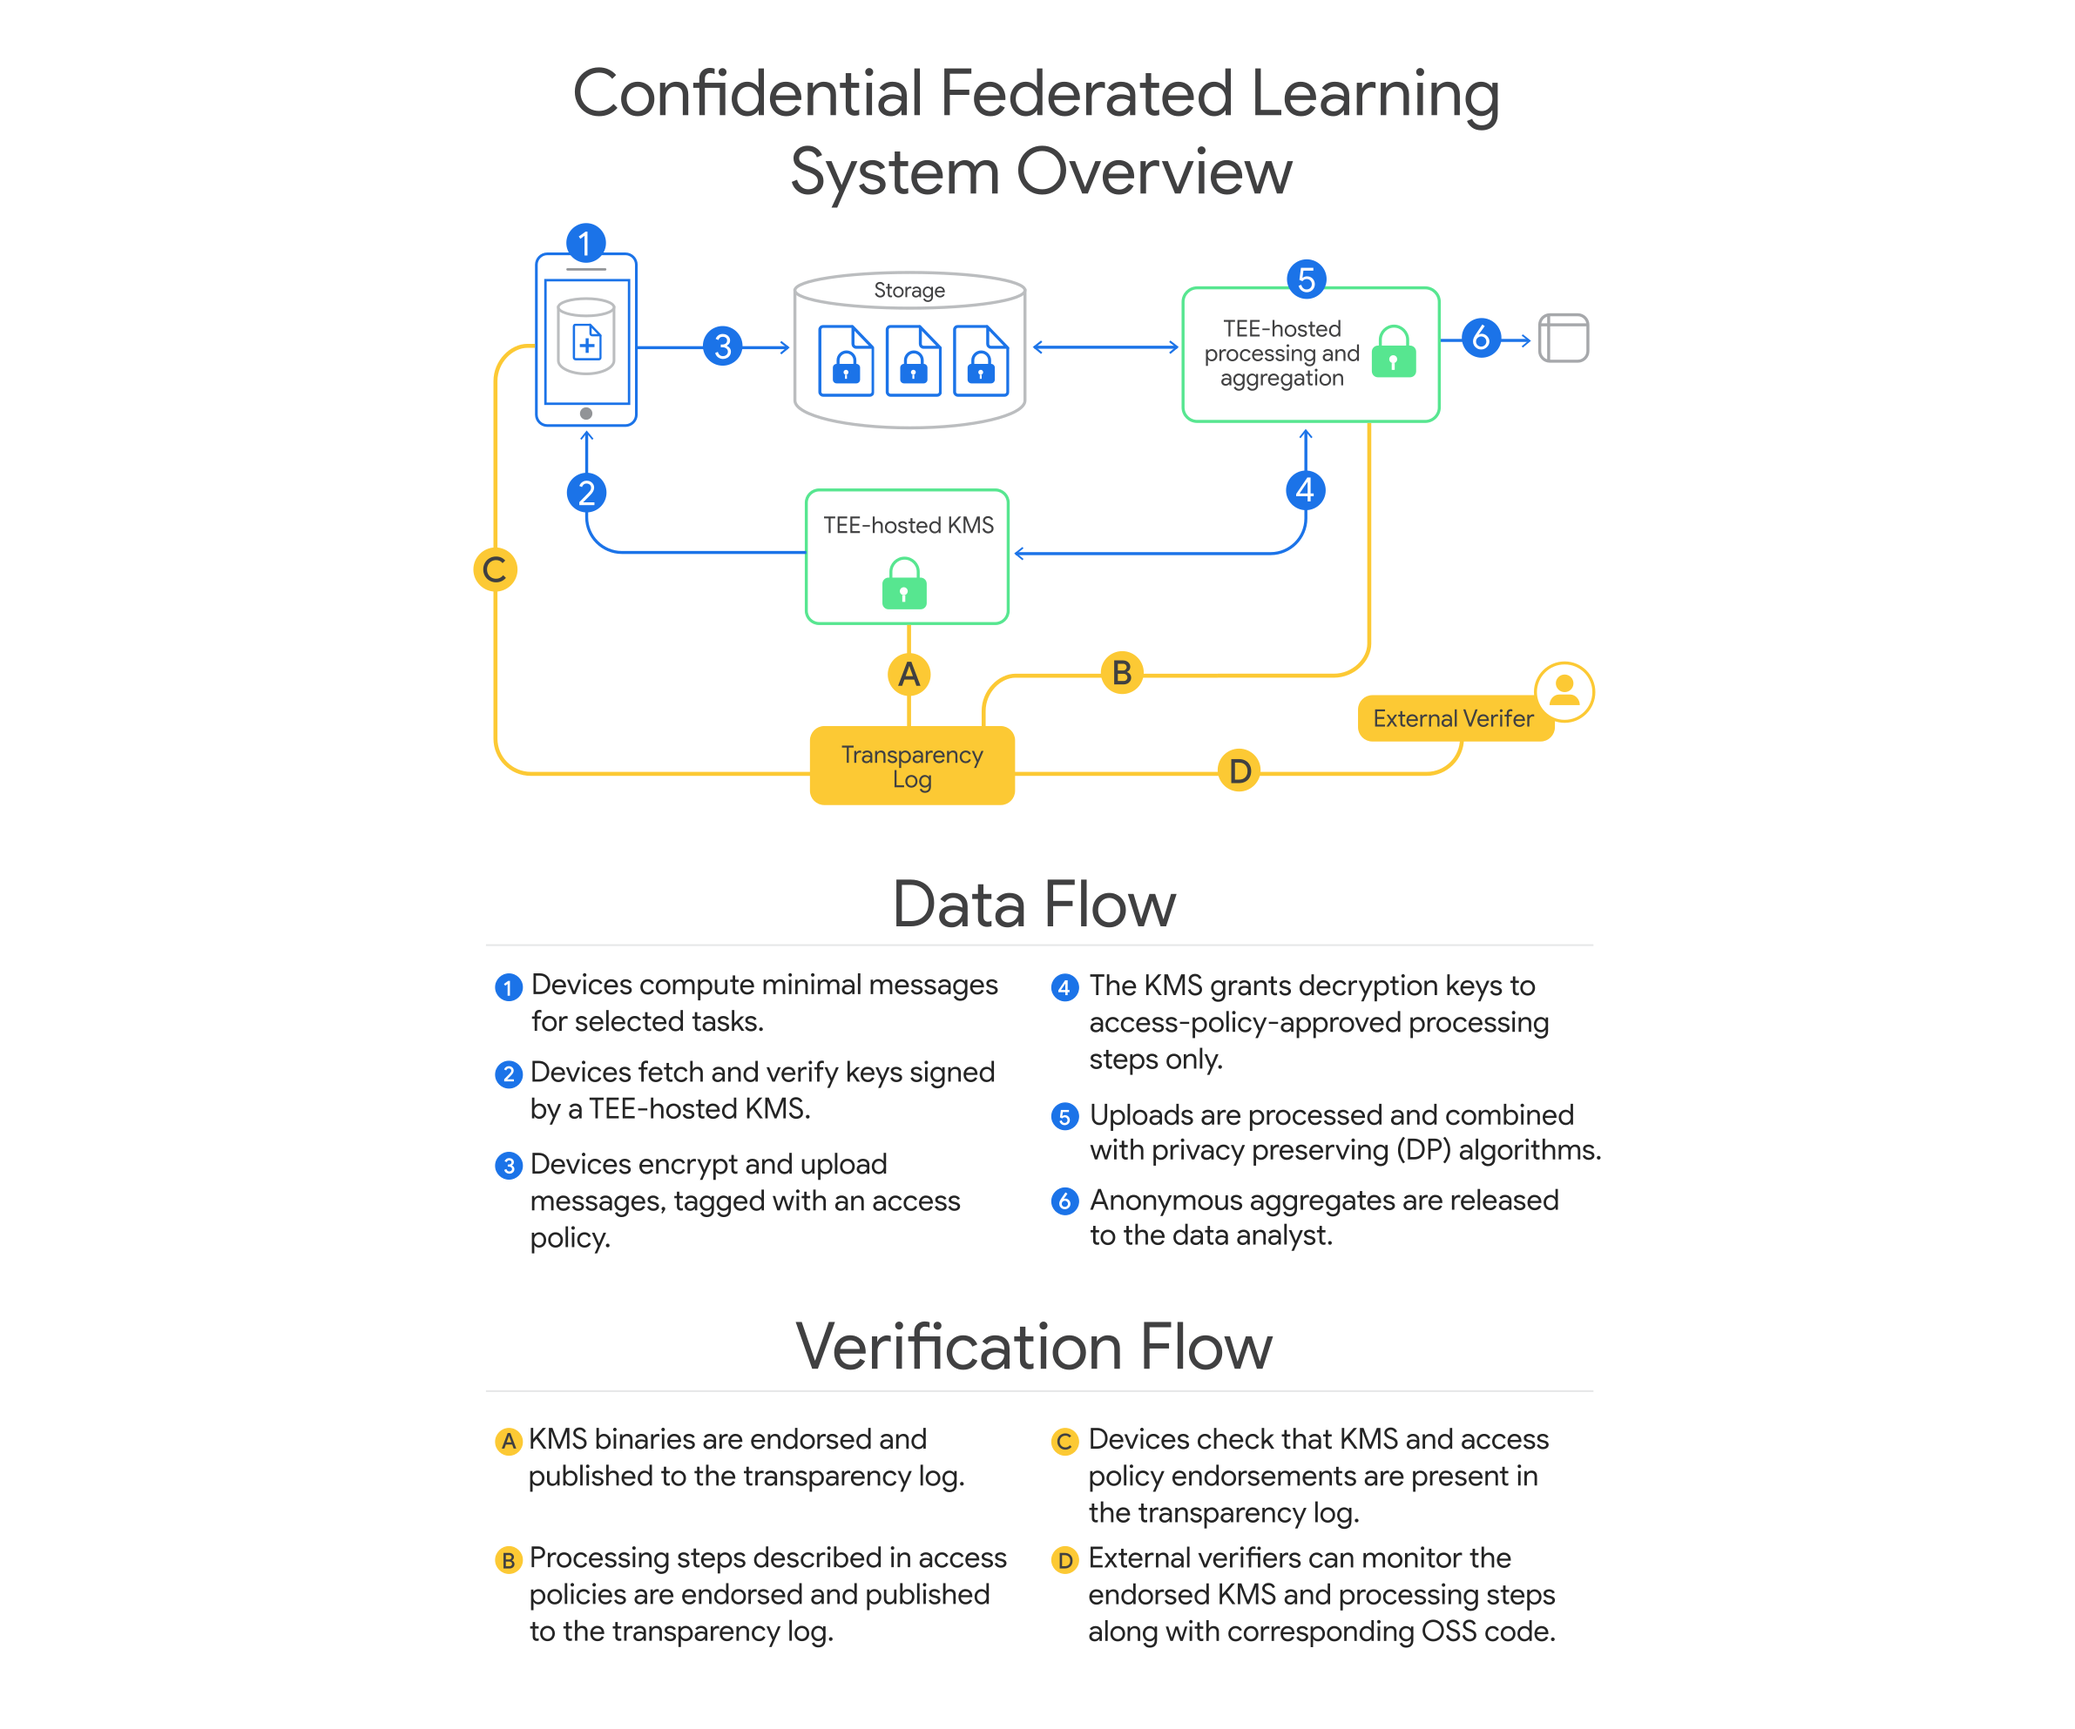
企业的专有技术则通过名为旁加载的通道得以保留。模型架构或数据预处理逻辑等难以公开的信息可在运行时加载到Python程序中,前提是所有与隐私相关的逻辑都必须固定写在程序里。白皮书指出,旁加载的信息既不加密也不开源,但审计方可以检查这些信息在程序中如何被使用,从而判断隐私保证是否得到维持。谷歌还表示,这一保证以侧信道观测等当前一代TEE的已知制约为前提。上传数据设有有效期(TTL),过期后任何TEE都无法解密,白皮书称KMS以尽力而为的方式执行这一TTL。
架构改变后,参与训练的设备数量首先发生了变化。在旧系统中,只有连接Wi-Fi、正在充电且电量充足的设备才能进入服务器选定的群组(cohort),并且必须当场完成计算。据白皮书,在旧系统上以6500台的群组规模、历时38天训练日语模型3000轮时,在3550万台符合条件的设备中,实际贡献数据的只有850万台,占23.9%。有2050万台从未收到服务器下发的任务,650万台收到了任务却因中断而未能完成。新系统则在约6天内先收集了1780万份上传数据后才开始训练,并将这1780万份全部用于训练。
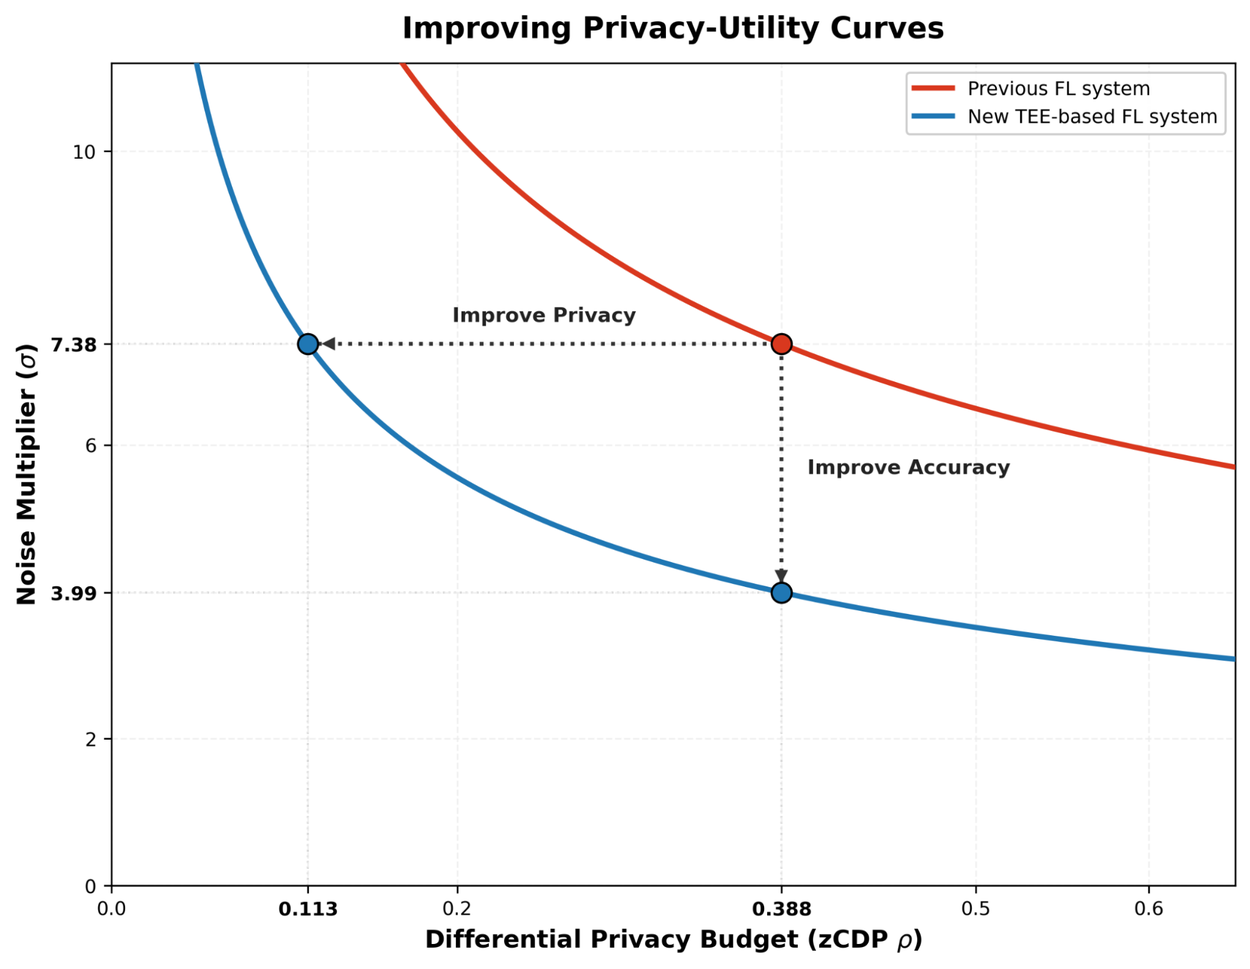
先把数据全部收集好,就能摆脱设备在线数量随昼夜波动的问题,由服务器为每台设备优化安排参与次数和间隔。在英语模型实验中,谷歌以5000轮时zCDP 0.232为隐私预算目标,并根据1180万份上传数据计算出所需噪声乘数为5.16。若要在旧系统中达到同样的预算,噪声乘数需提高到9.54。旧系统以7.38的噪声乘数在85天内运行了8616轮,设备每144小时只能参与一次。在5000轮时,单台设备参与的最大轮数从8轮降至3轮,两次参与之间的最小间隔从561轮增加到1822轮。
实际验证通过面向部分Gboard用户的A/B测试完成。Gboard的输入解码器在自动更正、单词补全和下一词预测中使用语言模型,每个实验组各有350万台设备。表现最好的TEE实验组zCDP为0.215,比按同一机制换算的现有生产英语模型的0.641小三倍。每分钟输入词数以及用户修改建议的比例等关键指标没有差异。白皮书写道,过去训练一个这样的模型需要一到两个月,而随着瓶颈转移到服务器端,即使只用14台机器,每轮训练时间也大幅缩短。
利用服务器芯片隔离区域保护个人数据的做法正在全行业扩散。白皮书列举苹果私有云计算、谷歌Private AI Compute和Meta Private Processing,作为在TEE或类似机密计算环境中运行大语言模型推理的近期案例。METAL曾报道谷歌公开服务器端AI记忆设计,此次发布则把同一思路从推理扩展到了训练。白皮书表示,迄今用新系统训练的模型最大为1000万参数规模,若要训练大得多的模型,工作TEE需要使用GPU。谷歌正在同一基础设施上测试合成数据生成任务,并探索与专门用于大语言模型推理的TEE结合使用。
从科技法律的视角看,这次发布的分量与其说在于准确率,不如说在于举证责任。迄今为止,处理个人信息的企业所作承诺依赖于政策文件和内部审计,用户和监管机构只能相信企业的说明。谷歌在设备上传之前就用公开日志锁定哪些代码可以接触数据,并让任何人都能重新构建这些代码进行比对,从而把承诺变成了可从外部核查的记录。白皮书承认,流水线运营方目前仍能看到每一轮使用了哪些上传数据,并指出若将其隐藏,就可借助抽样带来的隐私放大,在相同噪声下获得更强的保证。
戴利和拉米奇写道:"这项工作是朝着严格证明服务器端处理能够保护个人隐私迈出的一步。"他们表示,由于外部验证者可以查看谷歌究竟运行了什么代码,谷歌能够提供数据完全按所述方式处理的有力保证。谷歌预计,新一代TEE硬件和侧信道研究将保护动态加载的任务,并预期将来差分隐私算法和系统组件的整体实现都可能附带正确性证明。在用个人数据训练AI这件事上,信任的依据正从企业的声明转向任何人都能打开查看的日志。
评论