


摘要
- Google Research 于 9 月 24 日发布了整合 Co-Director、CANVAS、A²RD 和 VQQA 的长视频 AI 生成框架。
- CANVAS 报告背景连续性提升 21.6%,A²RD 一致性最高提升 30%,VQQA 在 T2V-CompBench 上提升 11.57%。
- 研究团队同时发布了一部十分钟的影片,所有输出都带有 SynthID 水印。
Google Research 于 9 月 24 日发布了一项长视频 AI 生成框架研究,该框架能够自主策划、拍摄并修正长达数分钟的视频。它名为 AI 视频联合导演,是构建在 Gemini 和 Veo 之上的编排层。研究团队把四个框架合为一体:确定故事方向的 Co-Director、保持分镜连续性的 CANVAS、逐段拼接长视频的 A²RD,以及发现缺陷并改写提示词的 VQQA。Co-Director 将在 COLM 2026 发表,CANVAS 将在 EMNLP 2026 发表。
研究团队想要解决的不是几秒钟的片段,而是故事。扩散模型能在几秒内渲染高清场景,但把多个镜头串起来时,人物服装或背景会一点点改变,出现语义漂移;上游一个小错误还会毁掉下游整段视频,形成级联失败。博客将其描述为经典的信用分配问题,即很难把最后才暴露的失败追溯到某个具体提示词。因此,目前这一流程需要无休止的人工修补。
第一阶段 Co-Director 把视频制作变成全局优化问题。编排智能体用多臂老虎机算法在创意策略、叙事方式和美学原型三个维度中选出组合,前期制作智能体把故事线和视觉素材整合成分镜。在制作智能体之下,关键帧、视频和音频智能体分别负责人物与场景、动作,以及旁白与配乐。多模态模型评审按三个维度给成片打分并反馈给算法,这个循环反复运行以优化选择。
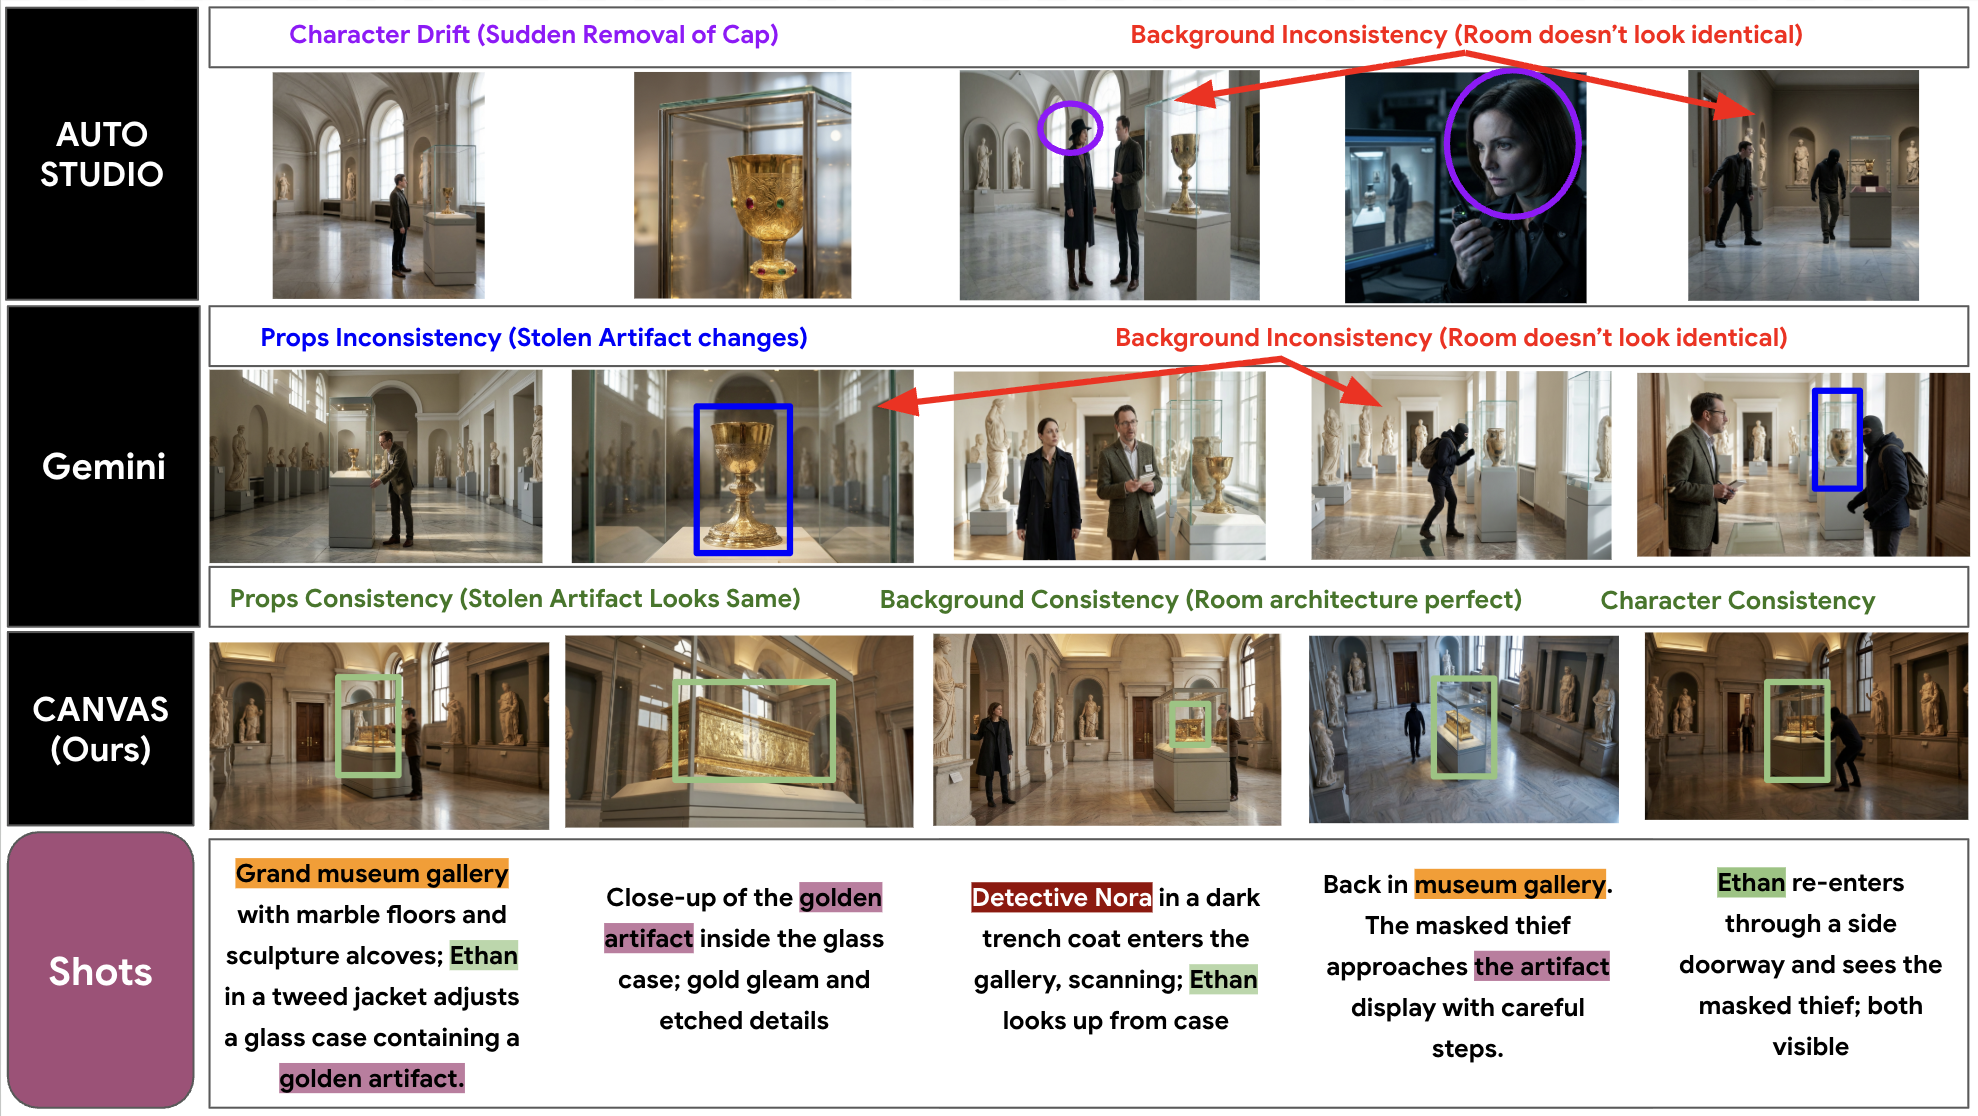
第二个框架 CANVAS 设有视觉记忆,记录人物、地点和道具的状态。在博客展示的博物馆盗窃场景中,仅用 Gemini 3.1 Pro 生成时宝石发生变化、展厅布局出现晃动;另一个多智能体框架 AutoStudio 则在镜头切换中让小偷的帽子消失了。根据论文,CANVAS 相比最强基线将背景连续性提升 21.6%,人物一致性提升 9.6%,道具一致性提升 7.6%。为了衡量这一点,研究团队还用 GPT-5.2 生成的多镜头分镜构建了新基准 HardContinuityBench。
第三个框架 A²RD 把分镜变成真正长达数分钟的视频。它对每一段运行检索记忆、生成、精修和更新记录的循环,推进故事时采用外推模式,把回归的人物和地点锁定到原有样貌时采用内插模式。研究团队公开了用这种方式制作的十分钟影片。论文称,在一到十分钟长度的视频上,它比现有最佳方法的一致性最高提升 30%,叙事连贯性最高提升 20%。评测集 LVBench-C 包含 120 个场景,并设定规则:关键素材必须消失至少 10 个片段,再以符合故事的变化形态回归。
最后的 VQQA 不在画面上涂改,而是修改文字。它针对提示词自动生成视觉问题,把视觉语言模型的批评当作指示方向的语义梯度来改写提示词。迭代结束时,全局选择机制会按原始提示词对所有候选重新打分,选出得分最高的视频。在 METAL 查看的博客 8 秒对比视频中,一个方形气球飘过圆窗的场景,基础生成画成了僵硬的红色盒子,而经过 VQQA 的版本画出了带有可见接缝的铝箔气球。按论文数据,这相当于在 T2V-CompBench 上绝对提升 11.57%,在 VBench2 上绝对提升 8.43%。
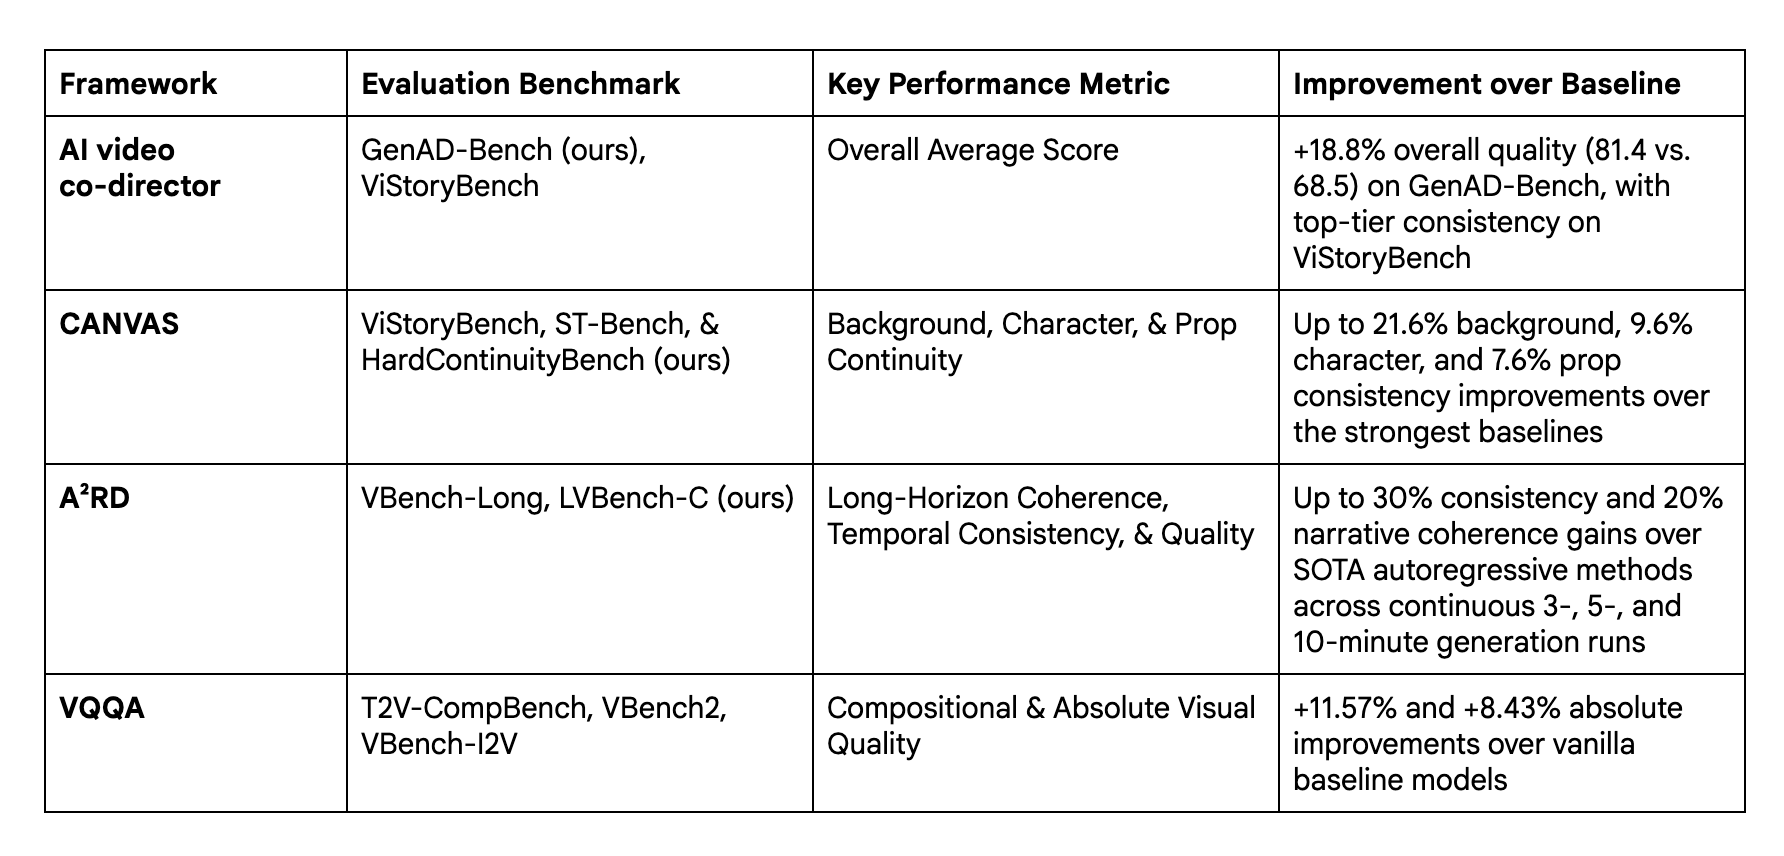
广告任务同样给出了数字。研究团队用 Gemini 3 Pro 和图像模型创建了 50 个虚构品牌、每个品牌 4 款产品,组成包含 400 个场景的 GenAD-Bench。这一设计用于检验能否遵守营销约束,而不依赖版权冲突或训练数据中的记忆。根据博客的评测表,Co-Director 在该基准上得到 81.4 分,比基线的 68.5 分整体质量高 18.8%。Co-Director 论文共有 16 名研究人员署名。
安全机制继承自基础模型。由于所有图像、视频和音频都经过 Gemini 和 Veo,SynthID 水印会原样保留;研究团队写道,在实际服务中还可以在整部成片上额外施加分类器,防范各自安全的片段拼接后产生的意外语境。其结构本身不绑定特定模型,也可以放在其他生成模型之上。METAL 曾报道视频生成速度超过播放时长的 MiniMax H3,而这项研究瞄准的不是速度,而是能维持数分钟的连续性。
从社会学者的视角看,这项研究改变的是导演工作的劳动分工。过去由片场场记负责的工作,即逐个镜头核对服装、道具和走位,将交给记忆系统和评审模型,人只需要决定讲什么故事。论文作者、Google 研究科学家 Yale Song 和 Yiwen Song 写道,他们把这个框架设计为"减轻维持视觉连续性的负担、让用户专注于讲故事艺术的响应式创作伙伴"。两人表示:"我们的最终目标不是取代人类的讲故事,而是赋能创作者。"研究团队表示,下一步将加入人可以中途介入的工作流程。连续性管理越多地交给机器,视频的作者身份最终就越取决于谁确定了创作方向。
信息来源
- Google Research — Automating coherent long-form video generation →
- arXiv — Co-Director: Agentic Generative Video Storytelling →
- arXiv — CANVAS: Continuity-Aware Narratives via Visual Agentic Storyboarding →
- arXiv — A²RD: Agentic Autoregressive Diffusion for Long Video Consistency →
- arXiv — VQQA: An Agentic Approach for Video Evaluation and Quality Improvement →
评论