


图片:@claudeai (X)(视频截图)
摘要
- Anthropic于9月28日发布Claude Sonnet 5.5,令牌单价与Sonnet 5保持一致,单项任务成本最多降低30%。
- 它在Terminal-Bench 4.0上得分70.6%,在GDPval-AA上得分1844,接近Opus 5.5;在Low或Medium设置下,以约十分之一的成本超过了Sonnet 5的最高分。
- 这是首款配备网络安全防护措施和推理提取拦截分类器的Sonnet模型,可在所有平台上以claude-sonnet-5-5调用。
Anthropic于9月28日发布了Claude 5.5系列的第二款模型Claude Sonnet 5.5。公司在发布文中表示,Sonnet 5.5的输出速度比Claude Sonnet 5快30%以上,在大多数工作中单项任务成本最多降低30%。令牌单价与Sonnet 5完全相同,成本的下降来自用少得多的令牌完成同样的工作。面向大批量、成本敏感场景的Claude Haiku 5.5将在未来几周内加入该系列。
两款模型的分工很明确。Anthropic将Opus 5.5定位为需要审慎判断的复杂工作,将Sonnet 5.5定位为范围明确的日常任务、修复程序缺陷以及撰写文档、幻灯片和电子表格。公司还补充说,它在设计上也很有眼光。METAL曾报道该系列首款模型Opus 5.5于9月22日发布,六天之后中端模型随之推出。
基准测试表显示,它与上一档模型的差距大幅缩小。在衡量命令行多步骤任务的Terminal-Bench 4.0上,Sonnet 5.5得分70.6%,远高于Sonnet 5的10.3%,甚至高于Opus 5.5在最高设置下取得的66.4%。在衡量44种职业真实工作的GDPval-AA上,它得分1844,比Opus 5.5的1846低2分,领先Sonnet 5的1449和GPT-6 Sol的1487。在计算机使用测试OSWorld 2.1上,它得分80.1%,紧随Opus 5.5的81.8%;在图表识读测试Chartography上,它从Sonnet 5的15.6%跃升至61.6%。在取材自真实Cursor编程会话的CursorBench 4.0上,它得分55.5%,比Opus 5.5的57.8%低约2分。它还是首款仅凭截图就通关《宝可梦 红》的Sonnet模型。
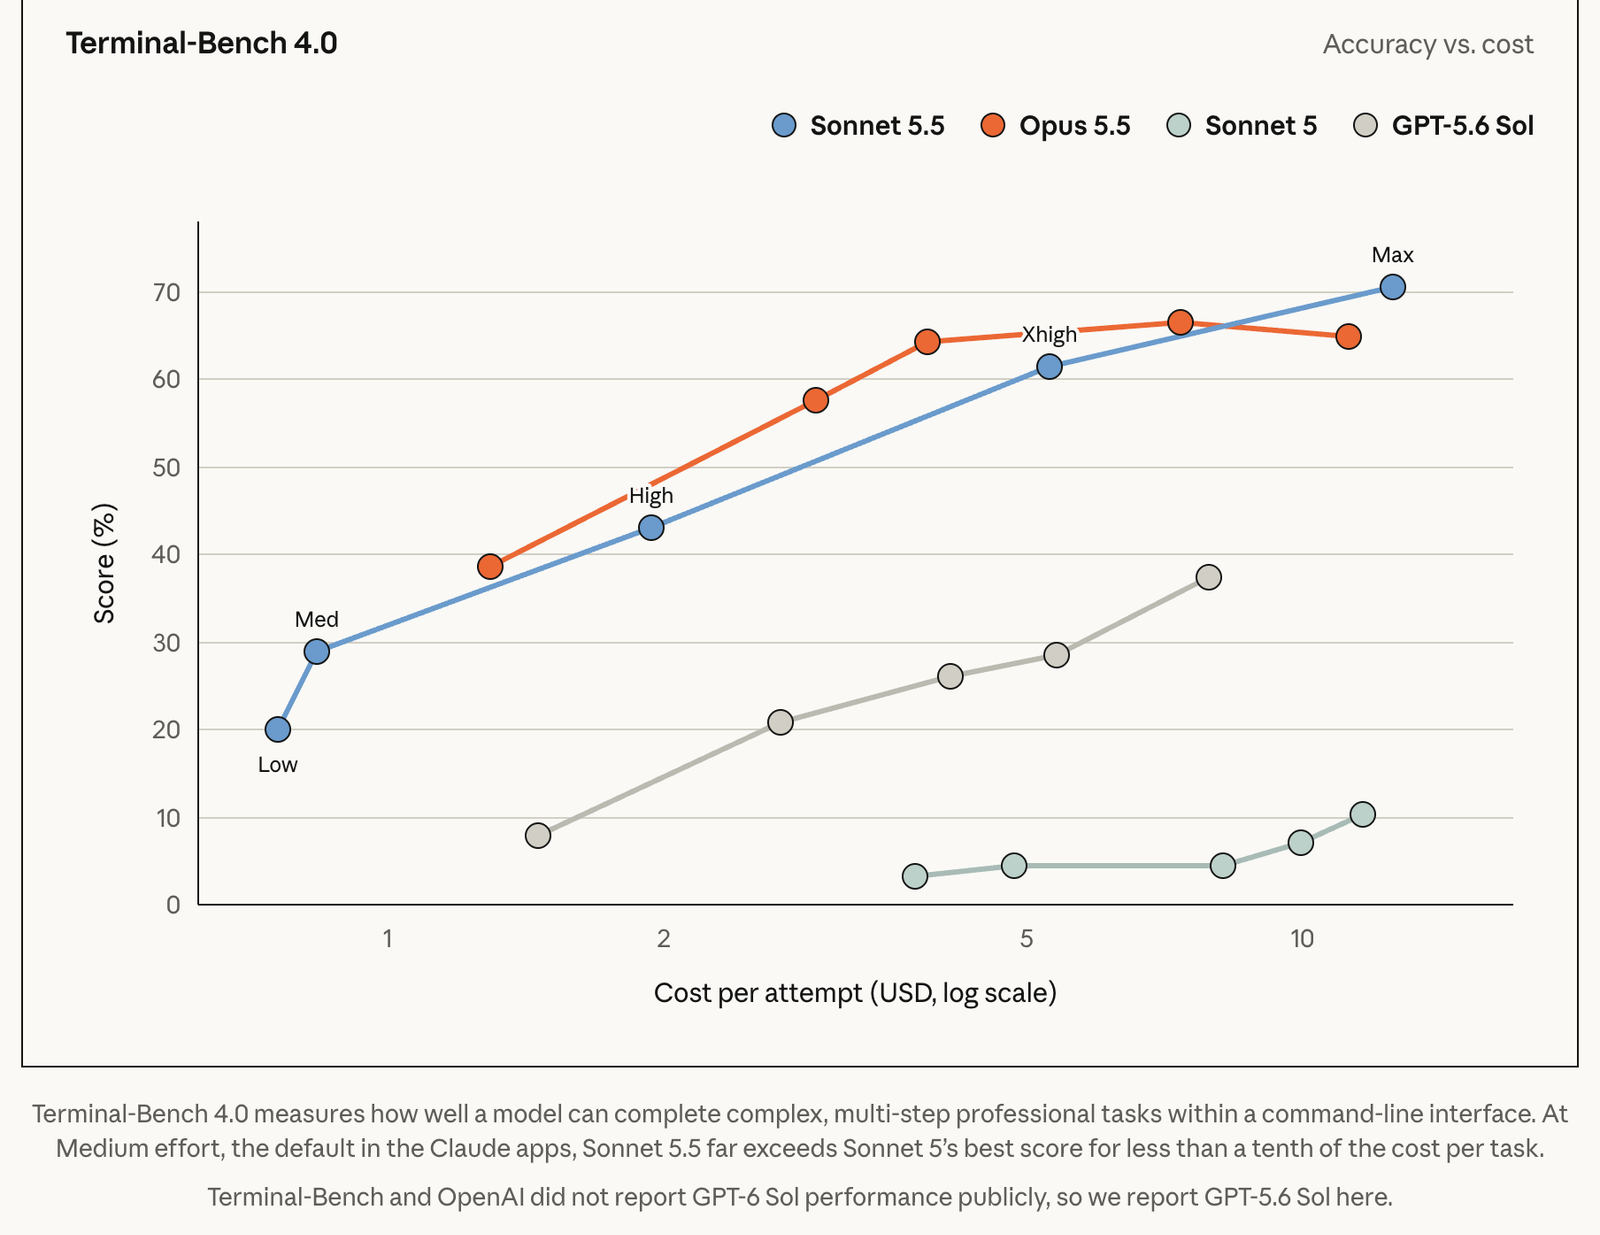
Anthropic更加强调的是每一分的成本。在公司公布的准确率与成本曲线中,Sonnet 5.5在多项基准测试上仅用Low或Medium设置,就以约十分之一的单项任务成本超过了Sonnet 5的最高分。在衡量代码改动能否直接合并的FrontierCode上,同为High设置时,它比Sonnet 5高出10分,而单项任务成本约为其十五分之一。Claude应用和Claude Code的默认设置为Medium,Claude平台的默认设置为High。把设置调到最高并不总是更好。在FrontierCode上,Max设置的得分为46.2%,低于低一档的Xhigh设置的52.1%。公司解释说,在Max设置下,模型有时会把代码审查拆分给多个子智能体运行,从而导致超时或超出任务范围的修改。Anthropic写道,在需要持续判断的开放式工作中,Opus 5.5仍然明显更强。
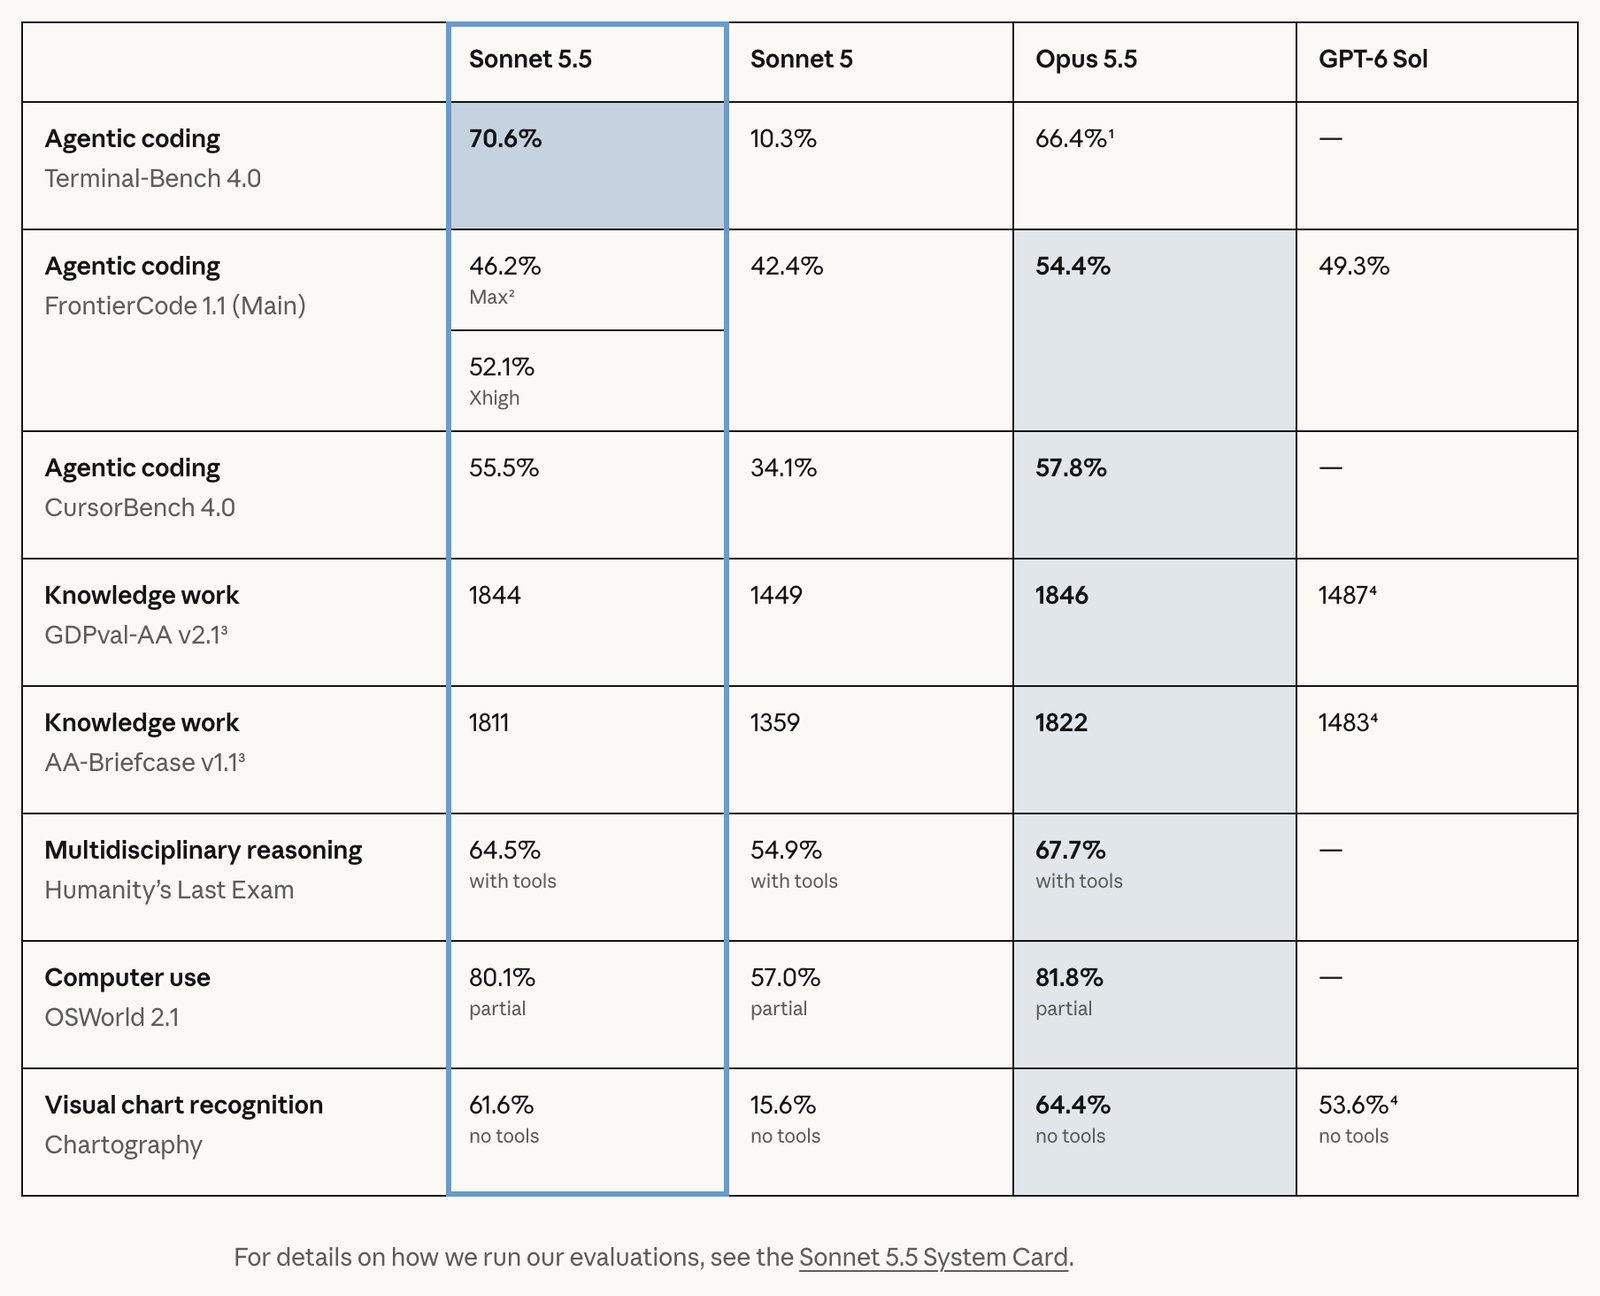
早期客户的数据都指向步骤和令牌的减少。Base44的AI工程负责人Gabriel Grinberg表示:"在118个真实应用构建中,Claude Sonnet 5.5做出的应用与Opus 5水平相当",并称"它平均每次构建只用了3.6轮迭代,而Opus 5需要7.7轮"。Balyasny Asset Management表示,在2441项金融任务中,Sonnet 5.5每个回答约使用12.1万个令牌,远少于Sonnet 5的49.7万个。Lovable联合创始人兼首席技术官Fabian Hedin表示,在其编程评估中,工具调用减少了三分之一,shell执行次数减少了约一半。
办公工具方面的结果也指向同一方向。Slack首席工程师Curtis Allen表示:"在没有修改任何提示词的情况下,Claude Sonnet 5.5在我们几乎所有离线Slackbot评估中都优于Sonnet 5",步骤更少,输出令牌减少约14%。Zendesk表示,在数百个真实客服案例中,该模型的错误判断更少,工单处理速度加快20%;Box表示,它比上一代模型更准确,速度快2.4倍,总令牌用量减少12%。在Anthropic的内部测试中,模型拿到一家上市公司的季度财报材料、电话会议记录和幻灯片模板,被要求制作一份10页的经营回顾,两名专家判定其初稿可以直接发送。
安全防护措施提升了一个层级。Anthropic表示,Sonnet 5.5的网络安全能力与Opus 5相当,因此它是首款配备最强模型所用网络安全防护措施和回退机制的Sonnet模型。日常的程序缺陷查找和修复不受影响,但高风险的网络安全请求会明显地回退到Sonnet 5处理。为应对利用数千个虚假账户大规模提取模型能力的蒸馏攻击,它也是首款配备推理提取拦截分类器的Sonnet模型,Anthropic还扩大了preserved thinking的适用范围,使模型的思考过程无法与创建它的账户分离。生物学防护措施与Sonnet 5相同。在涵盖约1850个场景的自动化行为审计中,Sonnet 5.5在大多数对齐指标上与Sonnet 5持平或更好;在隔离评估中,它试探容器边界的倾向是Anthropic所有模型中最低的。据报道,该模型还加入了为符合EU AI Act而设计的不可见文本水印。
该模型已登陆包括AWS、Google Cloud和Microsoft Azure在内的所有平台,开发者可以通过claude-sonnet-5-5调用。与Opus 5.5和Sonnet 5一样,它也可以在零数据保留的设置下使用。此前关闭思考功能使用Sonnet的开发者,在迁移前需要改用新的between_tools设置。METAL核实的Claude官方账号发布帖附有一段13秒的视频,核实时浏览量超过260万次,点赞超过3.1万个。视频中有一幕鸟群布满天空的画面,而发布文以"用一个HTML文件画出400只椋鸟的群飞"这一提示词作为速度对比示例。
价格竞争的坐标轴也在移动。据报道,OpenAI上周推出的GPT-6 Sol的标准API单价与Sonnet 5.5相同,谷歌则以更低的推广价销售Gemini 3.8 Flash直至年底。Anthropic在6月以推广价推出Sonnet 5,并在8月将该价格固定下来,METAL曾报道Sonnet 5推广价永久适用。这一次,它没有再调整单价,而是通过减少完成一项任务所需的令牌和工具调用次数来压低成本。
这次发布改变了企业挑选模型的标准。随着中端模型的得分逼近顶级模型,此前交给Opus处理的大量工作如今有了留在Sonnet上的理由。比较的单位也正从单个令牌的价格转向完成一项工作所需的总量,而Anthropic已经把这张计算表连同基准测试一起亲自摆了出来。
信息来源
- Anthropic — Introducing Claude Sonnet 5.5 →
- VentureBeat — Anthropic launches Claude Sonnet 5.5 with 30% cost reduction per-task due to faster speeds and fewer tool calls →
- SiliconANGLE — Anthropic debuts Claude Sonnet 5.5 running 30% faster than the previous-generation AI model →
- The New Stack — Anthropic launches Claude Sonnet 5.5 with near-Opus performance at half the price →
- Claude (X) — Introducing Claude Sonnet 5.5, the second model in the Claude 5.5 family. →
评论