


图片:METAL
摘要
- 据 OpenAI 于 10 月 8 日发布的案例,LegalOn Technologies 的 Codex 预估每日成本比只用 GPT-5.5 时降低约 65%,同时保持了开发速度。
- LegalOn 从轻量的 GPT-6 Luna 起步,标准设计交给 GPT-6.1 Sol,高难度判断和智能体调度交给 GPT-6 Astra,并默认关闭 Fast 模式。
- 成熟业务被要求把效率最多提高约 20%,新业务则获得充足预算;公司正在构建以功能发布为单位衡量 AI 投资回报的指标。
OpenAI 于 10 月 8 日发布了 LegalOn Technologies 削减 Codex 成本的案例。LegalOn 根据任务难度在 GPT-6 Astra、GPT-6.1 Sol 和 GPT-6 Luna 之间选择,并按业务阶段分配预算,最终使预估每日成本降低约 65%。据 OpenAI 介绍,开发速度保持不变,成熟业务部门则设定了把成本效率最多提高约 20% 的目标。
LegalOn 在全球提供用 AI 辅助法务等核心业务的"专业 AI"。OpenAI 将该公司归为亚太地区的初创企业。LegalOn 希望不仅让产品、也让组织本身以 AI 为核心,因此把 Codex 引入开发流程,随着日常使用的人越来越多,它扩展到了全公司。新的问题随之出现:无限制地使用高性能模型会推高支出,一刀切地限制又可能削弱 AI 带来的生产力。
起初,LegalOn 让开发人员以 Fast 模式无限制使用当时的主力模型 GPT-5.5。团队把用途扩展到设计、实现和日常工作,并通过实验摸索人与 AI 如何分工。但照此下去,显然会超出年度预算。公司内部的 AI 开发卓越中心 AID CoE 开始制定模型选择指南。AID CoE 测试模型、监控用量,管理者再把结果传达给团队,工程师由此能够自行为每项任务选择合适的模型。
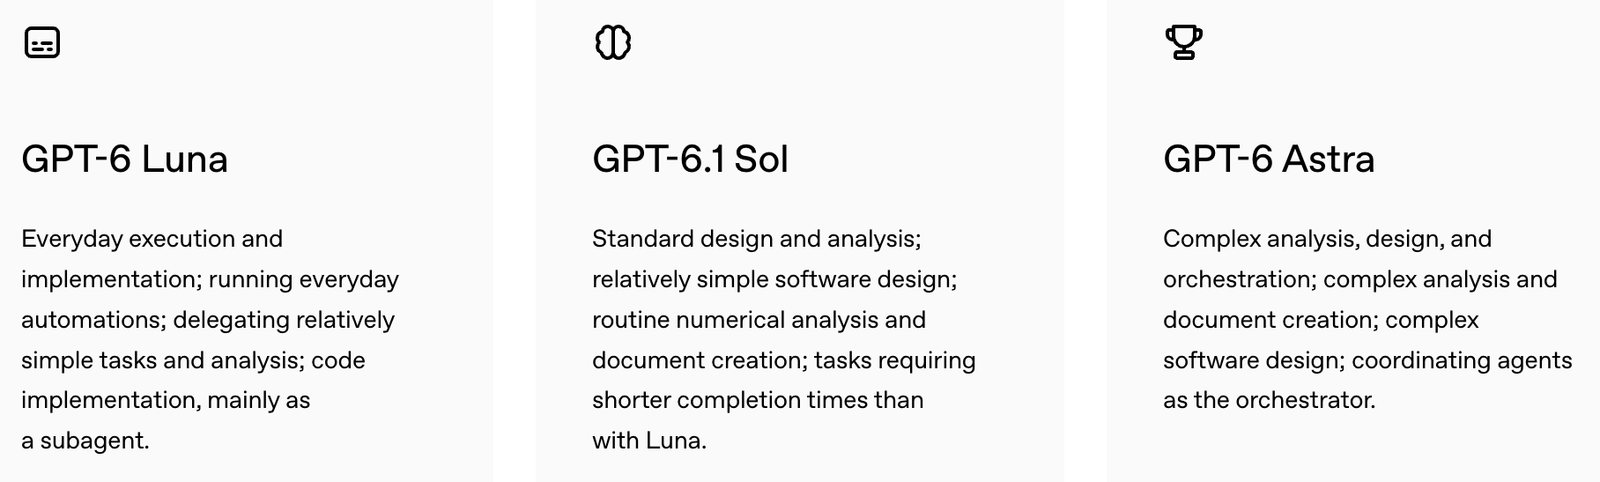
新指南的原则是从轻量模型出发,只有在工作变复杂时才向上切换。经过内部测试,标准变得更加具体。最轻的 GPT-6 Luna 负责需求明确的代码实现和日常自动化,主要作为子智能体工作。GPT-6.1 Sol 负责标准设计、数据分析和文档撰写,以及需要比 Luna 更短完成时间的任务。能力最强的 GPT-6 Astra 负责架构设计等高难度判断,并担任指挥多个智能体的编排者。
管控分为两层。通过管理员设置为部门和个人设定每月用量上限,AID CoE 根据用量调整上限。Fast 模式也被默认关闭,只在个人申请时开放。有人担心开发会变慢,但 OpenAI 表示,团队通过并行执行任务保住了效率。预算上限分为部门、小组和个人三级。
预算按业务阶段有意倾斜。既有的 LegalOn 业务被要求把成本效率最多提高约 20%,刚起步的新业务则获得充足预算,鼓励积极使用 AI。LegalOn Technologies 高级工程经理Yuta Tokitake解释说,新业务把业务速度放在成本效率之前,目的是大量使用 AI 提高产出,最终推动业务增长。模型选择、功能限制和分业务预算叠加后,预估每日成本比只用 GPT-5.5 时降低约 65%。
LegalOn 接下来关心的是回报而非成本。Tokitake 表示:"AI 能加快系统开发和更新,这几乎是理所当然的。我们真正想了解的是,更快的开发是否真的转化为客户价值。"因此公司正在构建自有指标,不再以开发速度或用量,而是以客户价值来评估 AI 投资。他说:"使用 AI 时可以追踪单项任务的成本,但功能发布这样一项完整工作的总成本往往仍是黑箱。"公司以每次功能发布为单位设计衡量方式,把该次发布带来的客户价值与实际投入的 AI 成本联系起来。计算该指标的管道目前正在搭建。
METAL 查看的 OpenAI 案例页面载有划分三个模型职责的表格,并附有 7 分 12 秒的语音朗读。METAL 此前报道过 OpenAI 发布 GPT-6 Sol 和 Luna 以及 GPT-6.1 Sol 上线,也介绍过同属法律领域的 Harvey GPT-6 Astra 案例。下一步,LegalOn 计划建立内部知识库,收集设计、实现和评审的最佳模型组合等实践经验。公司在招聘中已开始重视 AI 能力,AID CoE 与安全团队正共同平衡性能、成本和风险。
从工程管理的角度看,这个案例表明,模型路由如今已是开发组织的预算问题。只是把默认值从最贵的模型改为最便宜的模型、再逐级向上,就改变了成本结构。Tokitake 说:"用规则和预算过度限制,可能会损害组织的冲劲。我们需要的是一种灵活的运营模式,有效平衡风险控制与团队所需的速度。"
评论