


图片:METAL
摘要
- OpenAI 于 9 月 22 日宣布改进 GPT-6 系列的提示缓存,并推出缓存仪表盘和诊断工具。
- GPT-5.6 及之后的模型,缓存读取按输入单价的 0.1 倍计费,写入按 1.25 倍计费,缓存寿命至少 30 分钟。
- 诊断工具以模型、工具、推理强度、输入变化等九种原因解释缓存未命中,且不额外收费。
OpenAI 于 9 月 22 日宣布改进 GPT-6 系列的提示缓存。这项功能在多个请求共享相同开头部分时,复用已经计算好的状态;此次改进提高了默认缓存命中率,并将可获得缓存折扣的复用时间窗口定为 30 分钟。用于查看缓存表现的仪表盘,以及说明缓存为何未命中的诊断工具也同时推出。
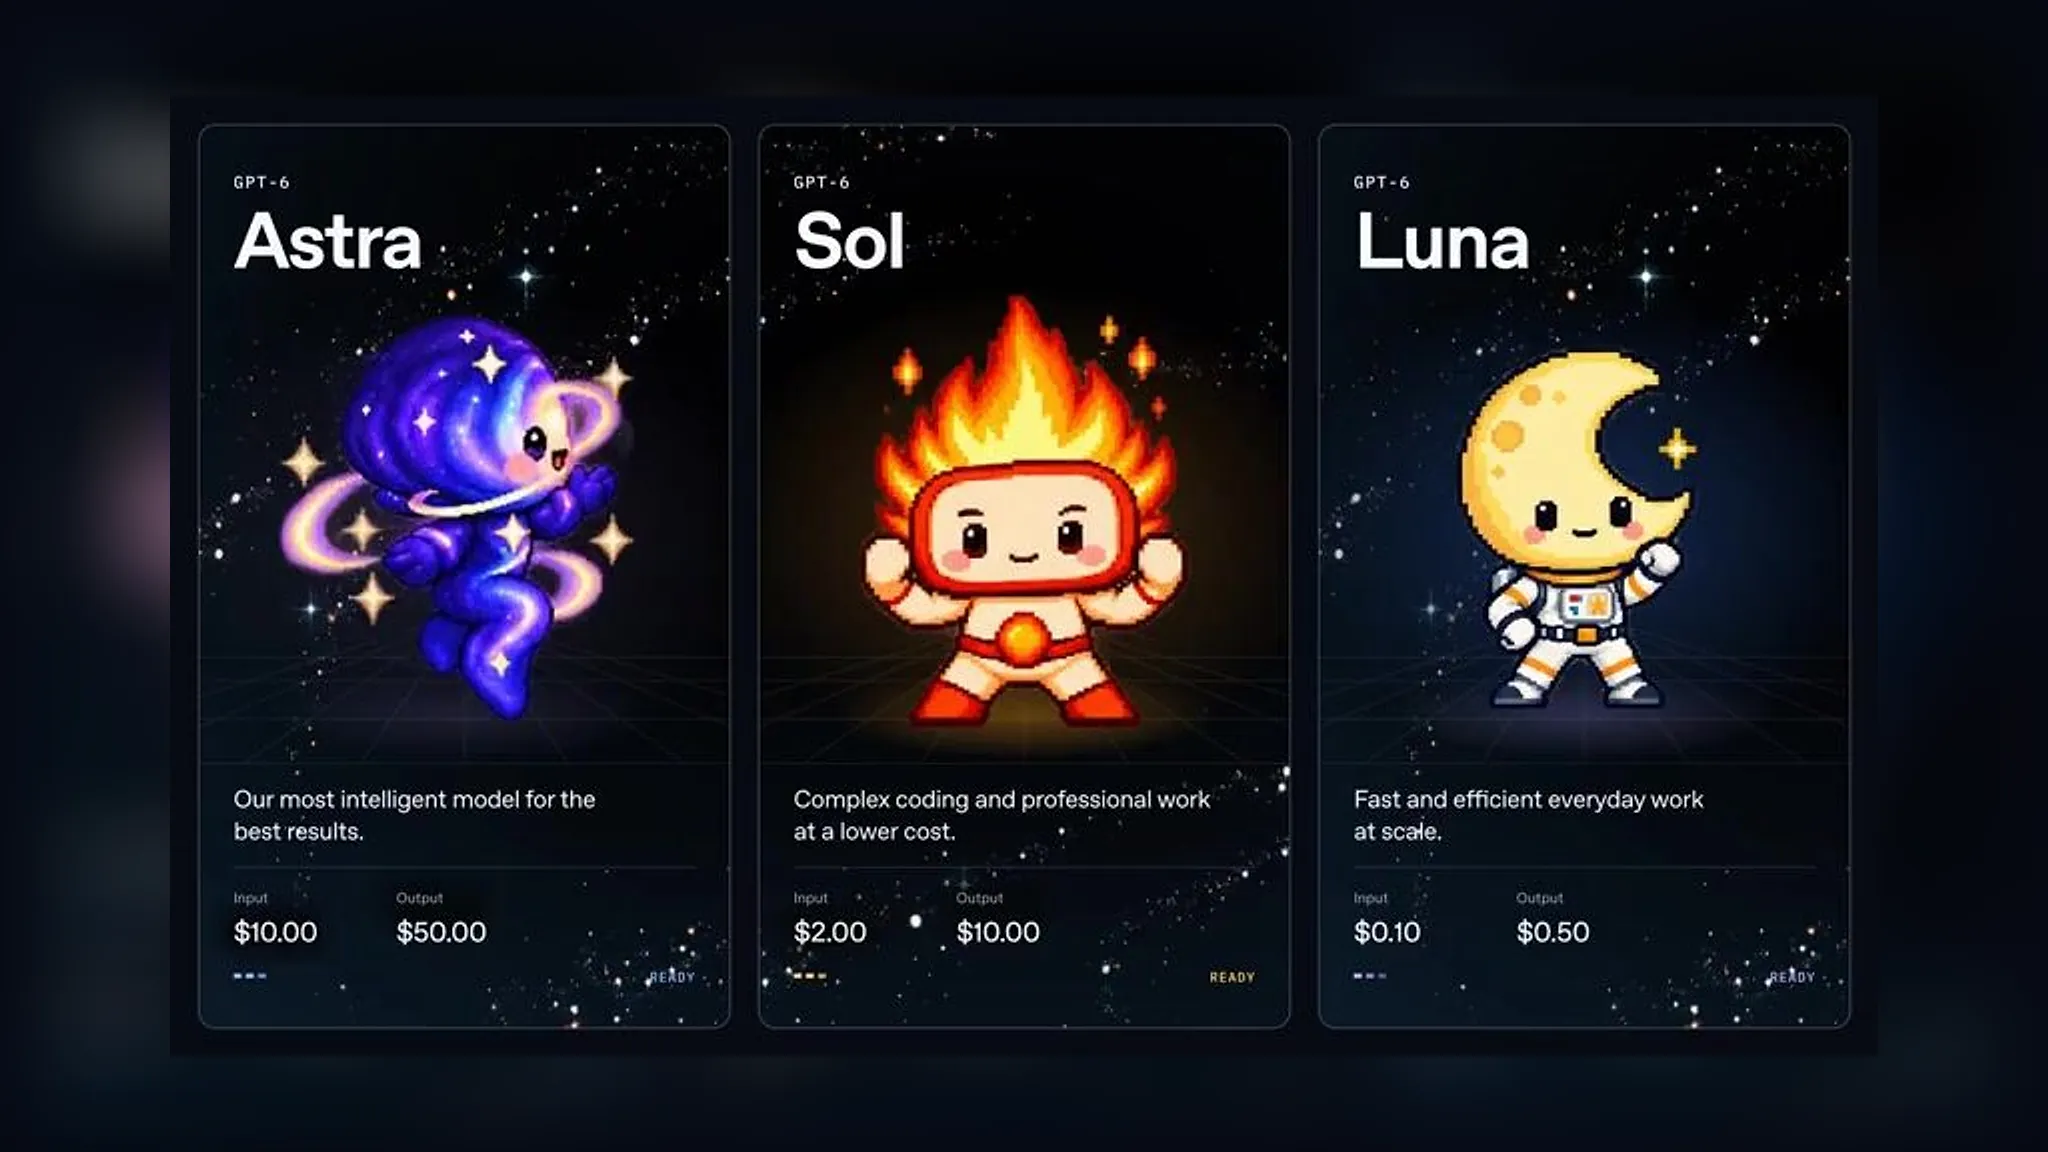
背景是连续运行数小时的智能体。据 OpenAI 介绍,GPT-6 让智能体能够连续数小时处理重构代码库、撰写调研文档和演示文稿等长任务,而驱动这些智能体的应用会原样携带前几轮的指令、工具定义和上下文,接连发出 API 请求。共享的开头部分一旦命中缓存,响应就会更快,缓存的输入令牌最多可享受 90% 的折扣。METAL 此前曾报道,OpenAI 在同一天发布 GPT-6 Sol 和 Luna 时预告了缓存折扣和新的缓存工具;这次发布则是结合开发者文档、说明这套机制实际如何运作的后续。
缓存保存的并不是文字。据开发者文档介绍,模型在处理输入令牌时会生成被称为键值状态的中间计算值,提示缓存会保留提示中未改变的开头部分的这些状态,供下一次请求复用。OpenAI 加入的隐藏系统指令、工具定义与模式、开发者消息、对话记录按此顺序叠加,前面任何一处发生变化,其后的内容都必须重新计算。
规则从 GPT-5.6 开始发生变化。可缓存的最小长度为 1,024 个可见输入令牌,并新增了由开发者自行设置缓存断点的显式模式。查找时,系统从最长前缀开始,依次回溯前 2 个和最近 50 个显式断点;隐式模式下还会加上最新用户消息的结尾以及此前最多 20 个消息结尾。GPT-5.5 和 GPT-5.5 Pro 按 2,048 个令牌的间隔设置边界,报告的缓存令牌数也会向下取整为 128 的倍数,而新方式会如实报告精确边界。
计费结构也有变化。在 GPT-5.6 及之后的模型上,缓存读取按未缓存输入单价的 0.1 倍计费,缓存写入按 1.25 倍计费,缓存寿命为最后一次写入或复用之后至少 30 分钟。写入缓存的前缀如果在 30 分钟内没有被再次读取,实际要比不使用缓存多付 25%,命中率因此直接等同于成本。
缓存存放在各台机器上。据文档介绍,每分钟超过 15 个请求时可能触发转向其他机器的溢出路由,此时请求可能无法到达持有缓存的机器。缓存不会在组织之间共享,也不会跨区域处理边界复用。
此次推出的工具让命中率变得可见。提示缓存仪表盘按时间显示输入中由缓存处理的比例,输入构成图则区分已缓存和未缓存的令牌。出现意外未命中时,可以用诊断工具把当前请求与最近的响应进行比较,找出模型、工具、设置和输入中哪一项发生了变化,并估算受影响的令牌数。
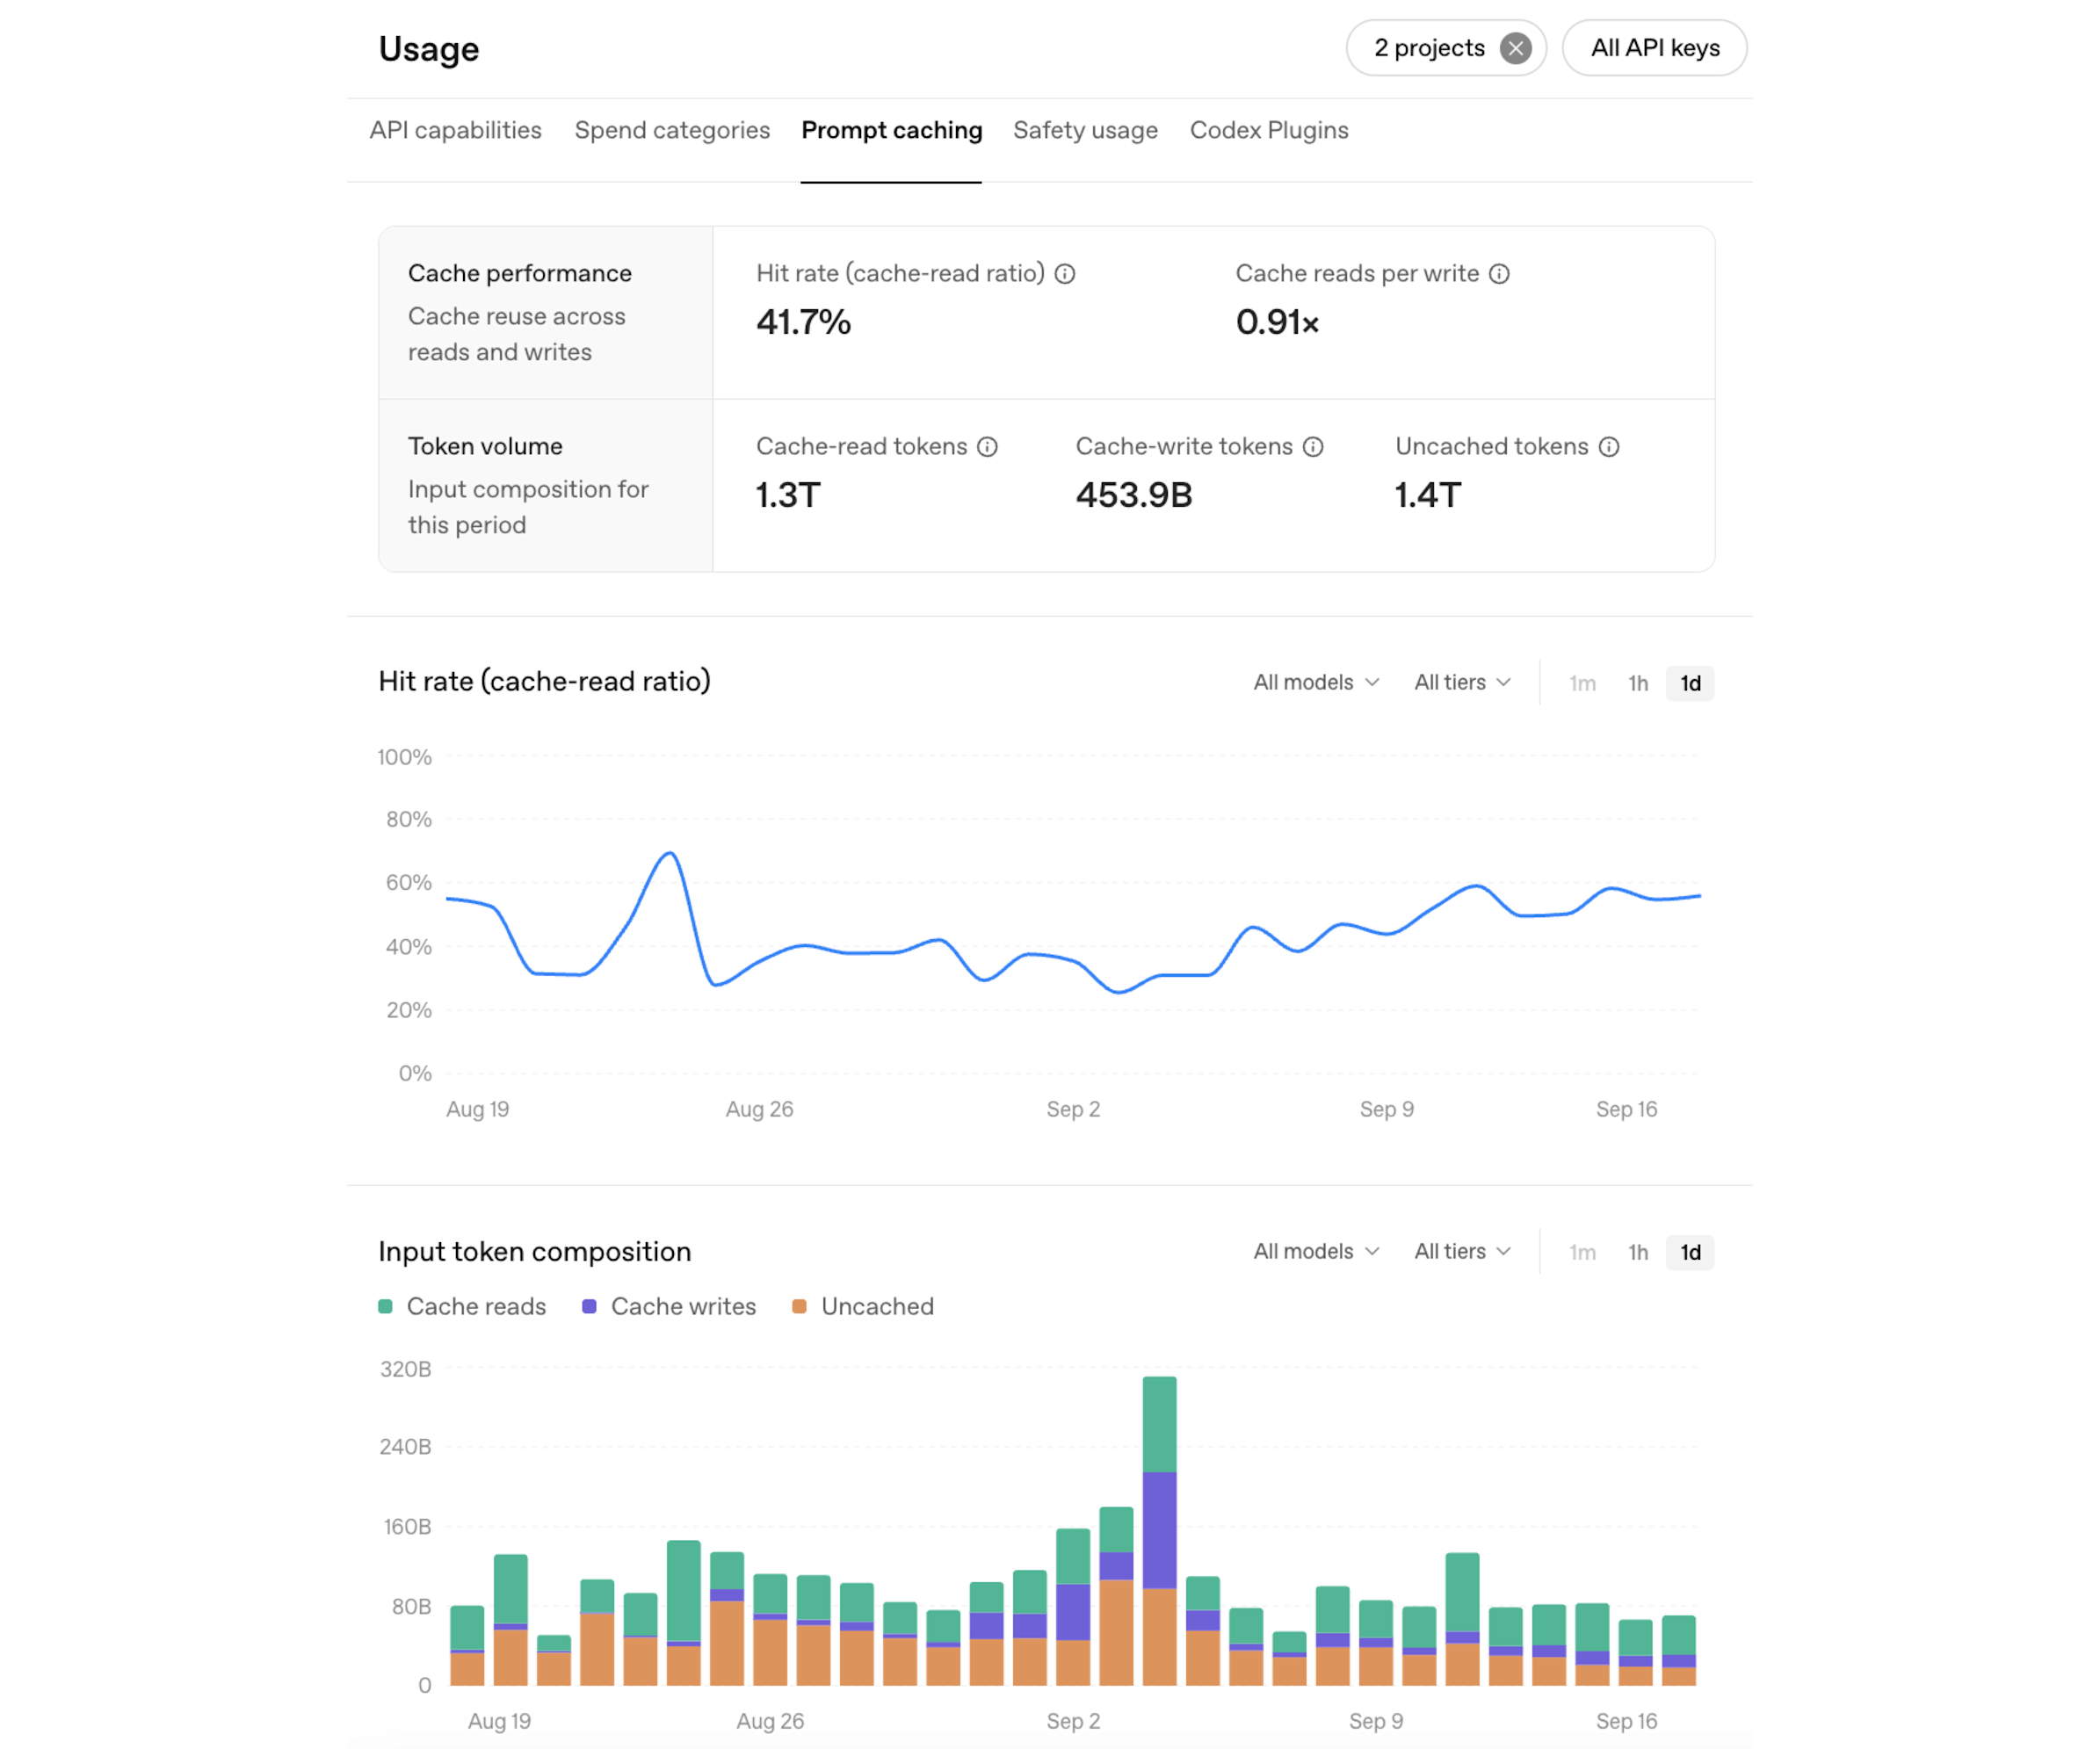
诊断会返回九种原因:模型变化、缓存键变化、服务等级变化、工具变化、输出格式变化、推理强度变化、回答长度设置变化、对话压缩以及输入变化。在文档示例中,仅仅把函数工具名从 get_time 改为 get_date,就有 5,629 个令牌完全没有命中缓存。诊断功能不额外收费,也不单独计入请求限额;它保存的不是原始提示,而是在短期内保存设置元数据、令牌估算值和哈希值,因此可以与零数据保留(Zero Data Retention)一起使用。由于一次只报告最先归类的一个原因,修复之后需要再次比较,才能看到下一个原因。
优化手段也整理为四类。开发者可以用显式断点选择缓存到哪里;在 GPT-6 模型上,保持请求级推理强度不变、追加 configuration_update,就能在两次响应之间调高或调低推理强度而不破坏缓存。不需要工具时,不要删除定义,而是用 allowed_tools 缩小可调用的工具范围,或将 tool_choice 设为 none;新的指令则以开发者消息的形式追加到上下文末尾。此外还加入了预热功能,在用户提出第一个问题之前,预先处理公共指令、工具定义和参考资料。
METAL 核实发现,诊断文档的原因表中仍将推理强度变化列为缓存未命中的原因。所谓可以自由调整推理强度,只适用于不改动请求设置、在后面追加 configuration_update 的新路径;如果直接修改请求中的推理强度值,前缀仍需重新计算。
客户也给出了数字。GitHub 首席产品官 Mario Rodriguez 表示:“过去几个月里,在发往 OpenAI 模型的数十亿次请求中,我们把需要重新处理的提示令牌比例较此前基线降低了 50% 以上。”打造智能体浏览器的 Strawberry 首席技术官 Arian Hanifi 表示:“借助仪表盘和诊断工具,我们把缓存命中率提高了几个百分点,成本降低了 20%。”他补充说,缓存意外失效时团队会收到警报,并用 Codex 智能体查找根本原因;用显式断点缓存稳定的上下文,同时把频繁变化的内容放在提示末尾,使得为后台任务分叉对话在经济上变得可行。
从智能体工程的角度看,这次发布与其说是折扣功能,不如说是一种设计纪律。在长达数小时的任务中,输入的大部分是已经计算过一次的前缀,能否守住这段前缀,同时决定了延迟和账单。在指令顶部放一个时间戳、调整工具顺序这样的小习惯,就会让数千个令牌被重新计算,而 OpenAI 如今开始用原因代码和令牌数把这一事实反馈给开发者。构建智能体应用的团队首先要做的不是更换模型,而是先写下自己的提示中每次都会变化的内容是什么。
评论