


图片:Black Forest Labs
摘要
- Black Forest Labs发布了参数规模为7B的开放权重世界动作模型FLUX 3 Action。
- 该模型RoboLab成功率达42.92%,同时超过了16B的Cosmos 3 Nano和3.3B的π0.5。
- 与GPT-6 Astra组成的混合系统解决了90%的任务,同时将每次成功的成本降低了29%。
Black Forest Labs凭借图像生成模型FLUX打响名号,9月却拿出了一款风格迥异的模型。它不是用来画图的模型,而是用来操控机械臂的模型。这款模型名为FLUX 3 Action,简称F3A,是一个参数量为7B的开放权重世界动作模型。公司没有只甩出权重了事,还同步公布了一份报告,涵盖从预训练、微调到推理优化的全过程。
世界动作模型这个说法乍一听有点陌生。模型会观察工作台上多个摄像头拍到的画面,由同一个模型同时预测下一时刻的画面和机器人的下一步动作。说得简单点,世界动作模型就是让同一个模型把接下来会出现的画面和机器人的下一步动作一起给出来。这有点像伸手去拿东西之前,先在脑子里把那个画面想一遍再动手。因为同时预测画面,从海量视频中学到的世界运作直觉,也就顺势带入了动作预测里。
问题是,这种直觉并非免费获得。迄今为止公开的机器人策略都逼着人在两者之间二选一。同时预测画面的世界动作模型效果好,但速度慢、负担重;只看画面和指令就直接给出动作的视觉-语言-动作模型速度快,但成功率大打折扣。拿开车打比方,一种司机会先在脑子里把前方十秒的画面过一遍再转动方向盘,另一种司机只看挡风玻璃前方凭反射动作转弯。前者做得更好,但思考的这段时间里,车已经往前开出去那么远了。
数字摆出来,差距就很清楚了。NVIDIA的Cosmos 3 Nano在RoboLab基准上成功率为36.8%,参数量是16B。3.3B的π0.5则只有28.0%。在B200 GPU上以FP8运行的Cosmos 3 Nano,生成一秒机器人动作所需的处理时间约是以BF16运行的π0.5的4.7倍。选表现更好的一方,就要为延迟和硬件成本买单;选速度更快的一方,则要放弃将近四分之一的成功尝试。
F3A把这道选择题直接取消了。只采样一次的7B检查点在RoboLab上拿到38.3%,是已公开策略中最高的成绩,在工作站和数据中心GPU上都比π0.5快1.34到2.28倍。如果愿意牺牲一点延迟,经过引导蒸馏的检查点能把成功率提高到42.2%。排行榜上的数字是42.92%,以不到一半的体量超过了16B模型。以FP8计算,比Cosmos 3 Nano快1.52到3.95倍。而且它一次能规划的时间跨度是2.13秒,比π0.5的1.0秒长出一倍还多。
秘诀主要有两个。一个是公司称为Self Flow的多模态预训练:混合训练图像、视频和音频,其中视频占了95%以上的token。效果由对照组证明:没有经过预训练、只用机器人数据训练的检查点,在RoboLab上连1%都没能超过;而经过预训练的版本从11.6%起步,一路提高到12.4%。也就是说,单靠机器人示范数据从一开始就不够用。
另一个是蒸馏。为了提高质量,过去每一步都要多算一遍的引导计算被融合进学生模型里去掉了,由此获得1.8到2倍的提速,采样步数本身也压缩到了一步。重要的是,这一切是在不切断画面和动作之间联系的情况下做到的——此前的方案要么切断两者的相互作用,要么干脆多用一块GPU,才能换来速度。
训练用的素材同样值得留意。带有动作标注的视频占全部训练样本的63.05%,在总体样本中,游戏录像占19.55%,标注了手部姿态的第一人称视频占13.54%,人手持抓具的画面占14.03%,14种机器人的遥操作记录占15.93%。剩下的36.95%是带声音的普通视频。这意味着直接来自机器人本身的数据,只占全部素材的六分之一左右。
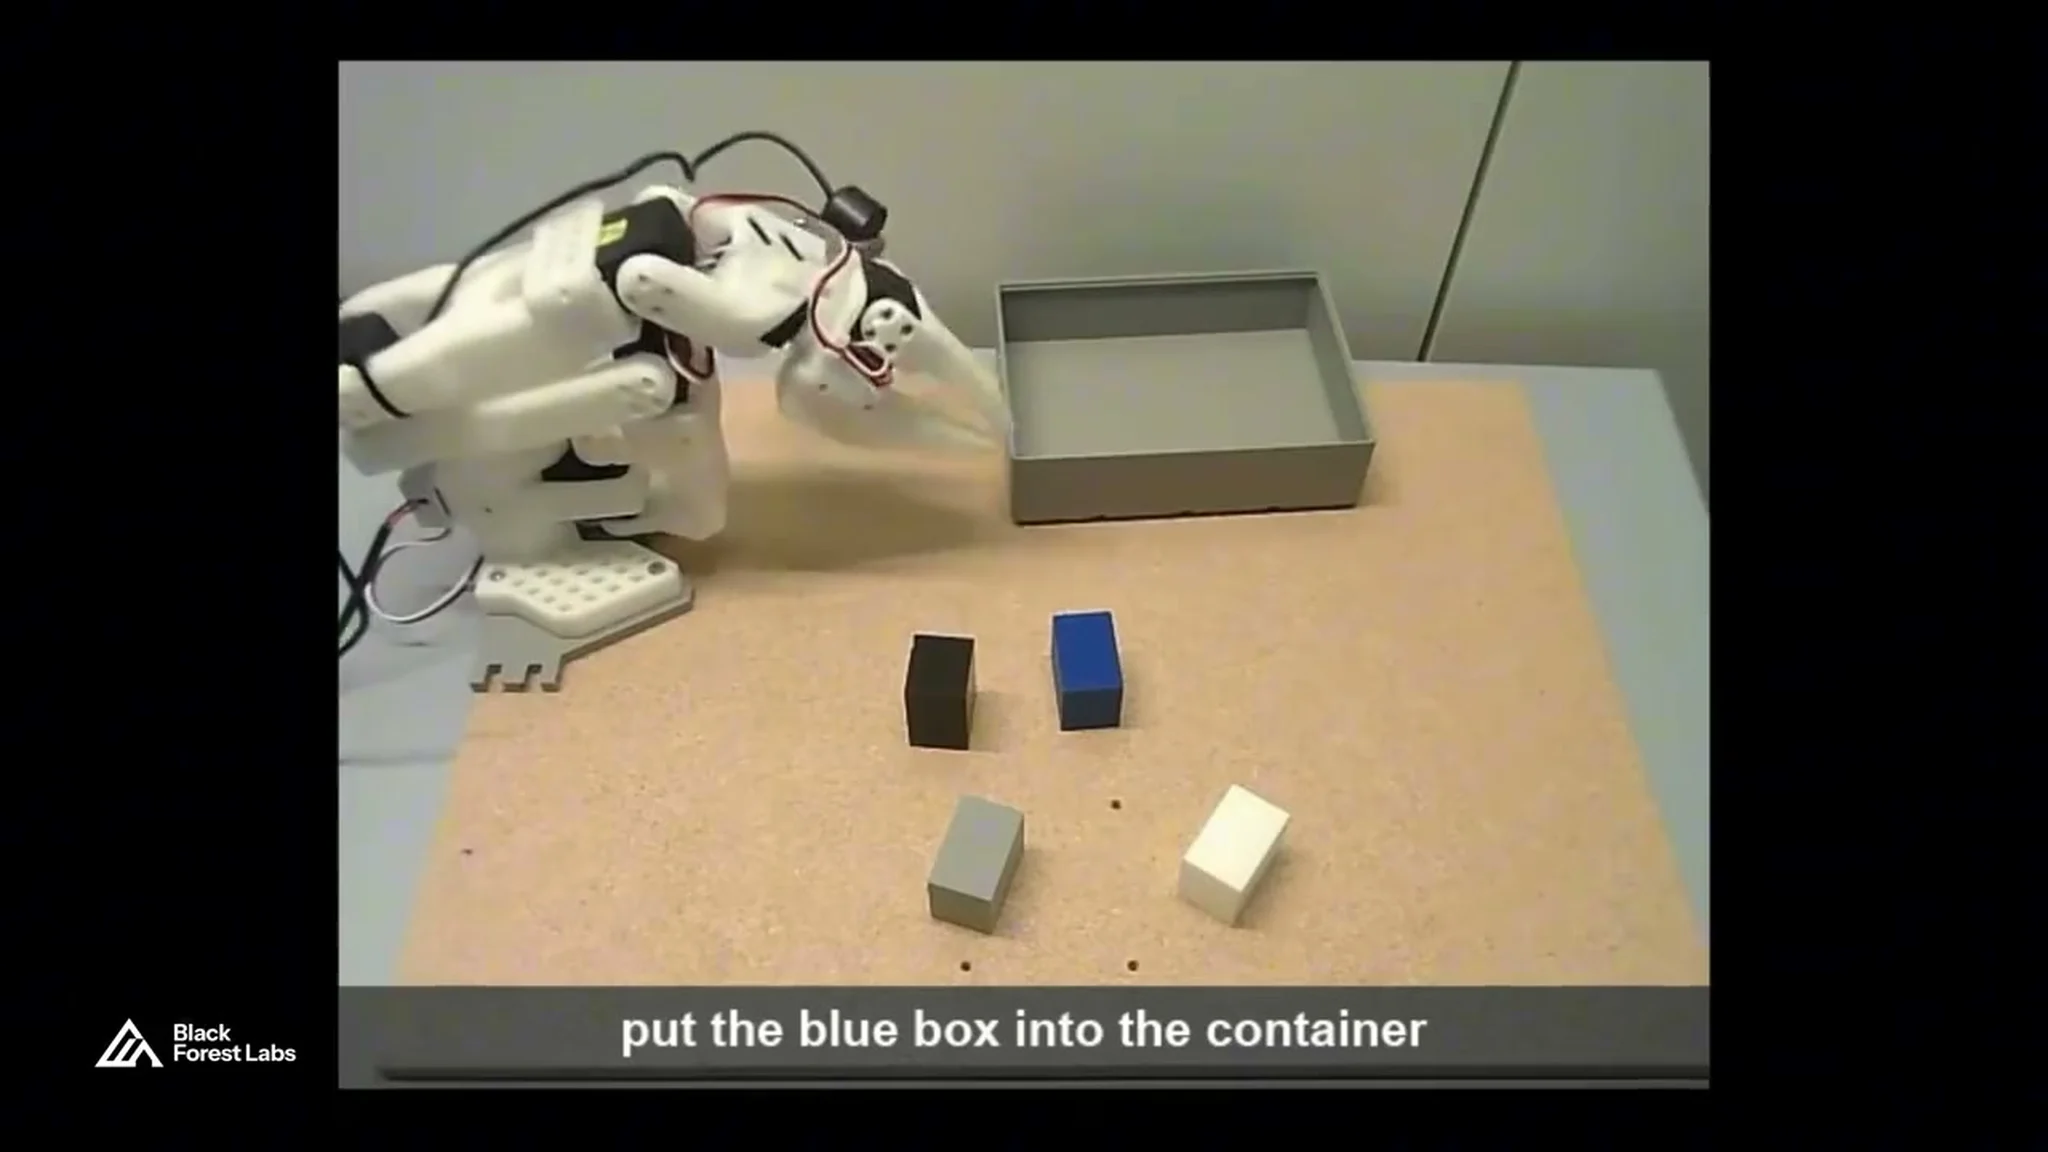
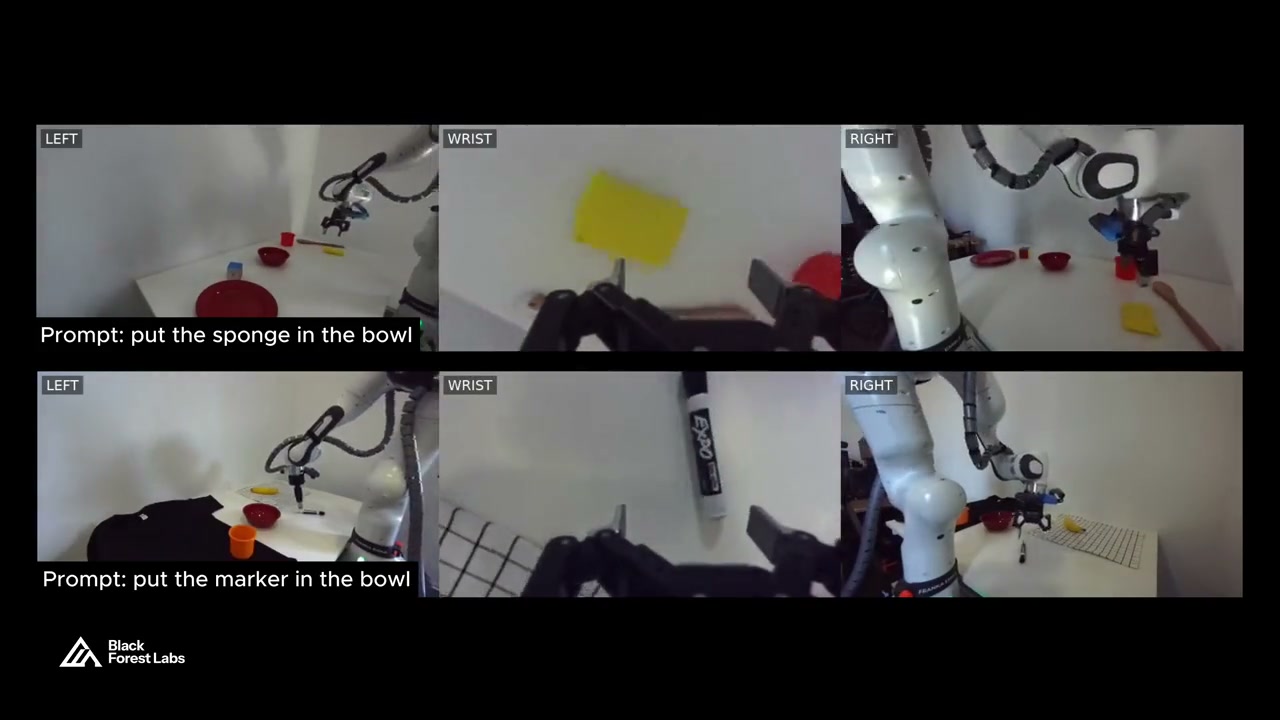
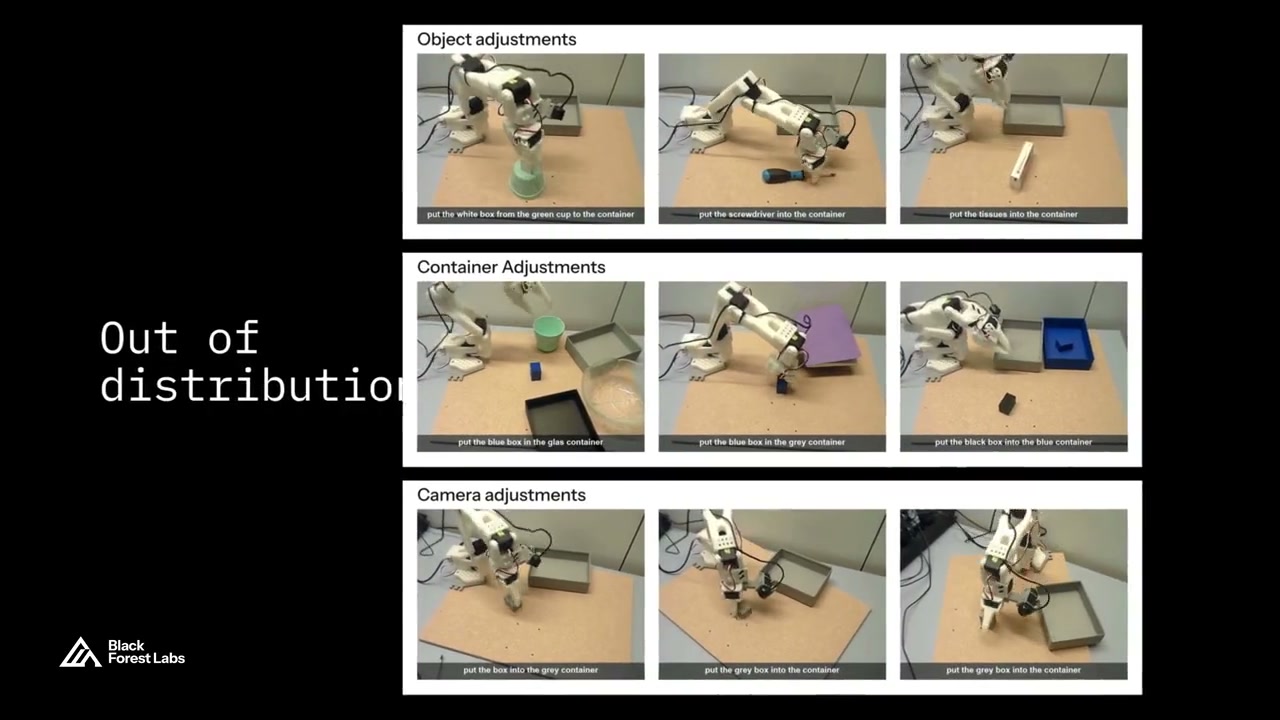
光靠仿真成绩没法让人信服,这是机器人领域的常态,所以团队也在真实机械臂上做了验证。Positronic Robotics把这套策略装到自家实验室的Franka机械臂上,把DROID的10项任务各跑了三次。所有模型拿到的任务、设置和每次尝试的240秒时限都一样,操作员也不知道是哪个模型在控制机械臂。F3A在30次尝试里完成了28次。同样的方案也用在了更便宜的SO-101机械臂上,即便物体、容器和摄像头位置都和训练时不同,它依然能把任务做完。
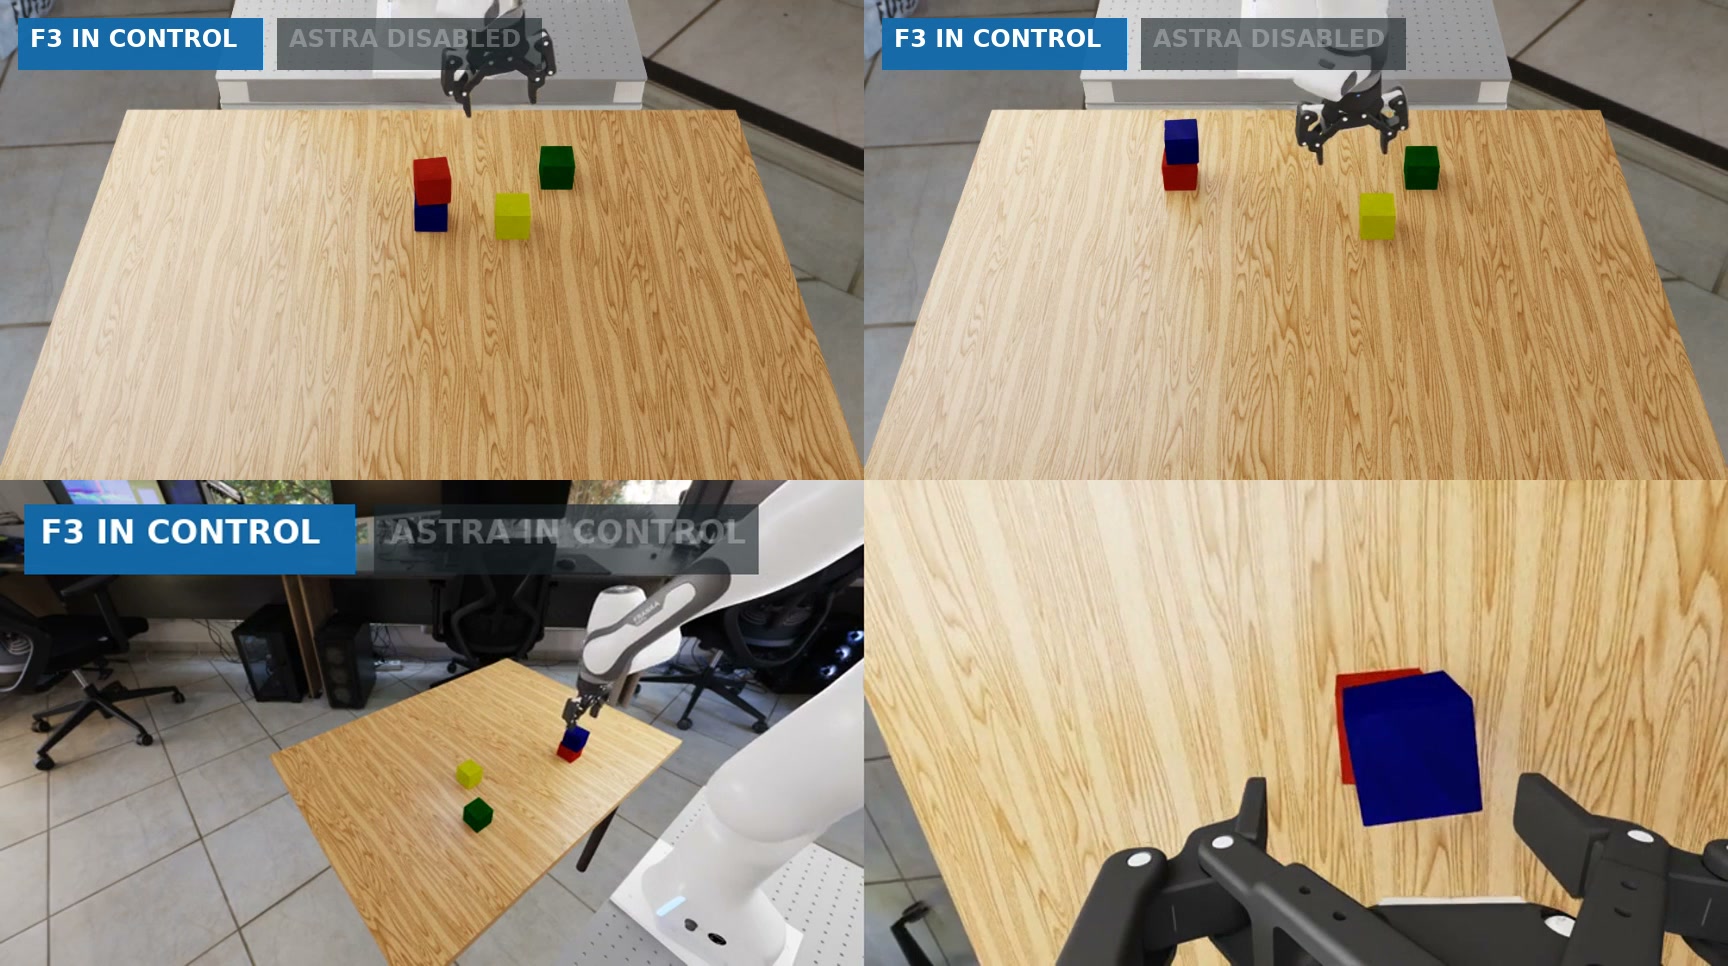
最有意思的实验,是把F3A和推理模型搭配起来测试。GPT-6 Astra把推理开到最大时,能解开这个基准里的所有任务。但代价是每调用一次,每一秒机器人动作就要多花35.77秒,每次成功平均要花13.47美元、耗时16分钟。F3A处理同样的一秒只需要21.08毫秒,在每小时3美元的单张H200上,每次成功只要0.09美元,耗时不到2分钟。这2分钟里大部分时间,模型都在机器人移动的间隙里闲着,所以在同一块GPU上多跑47次rollout,成本也不会增加。不过,有些任务它单靠自己终究解不开。
于是团队搭建了一套结构:平时由F3A负责控制,只有在需要时Astra才介入。每一轮,F3A先给出预测,Astra再决定是执行其中一部分、修改其中一到五步、提出自己的动作,还是直接叫停。这套混合系统解决了90%的episode——包括任何单一动作策略都解不开的任务——同时把每次成功的成本降到8.77美元,耗时降到8分钟。如果用π0.5搭建同样的结构,成本是12.28美元,和纯推理的13.47美元相差无几。快速策略越强,整个系统需要思考的量就越少。
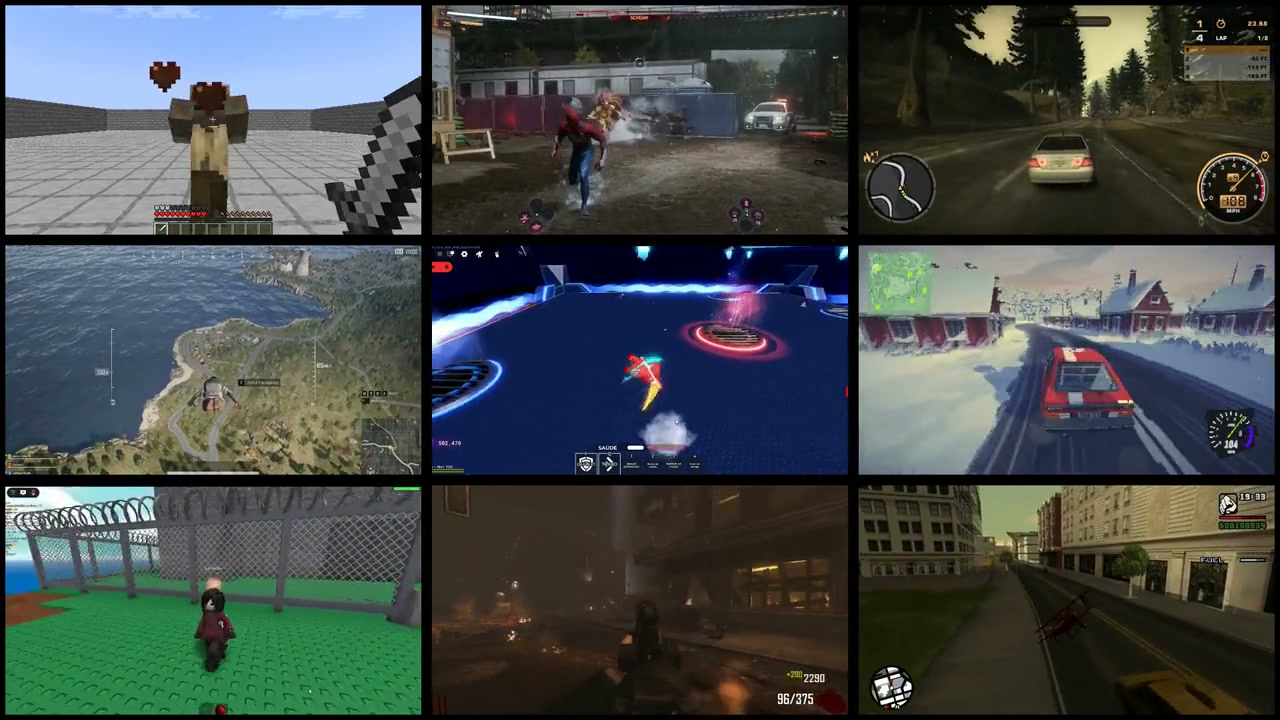
公司为什么加入这么多游戏数据,报告末尾也做了解释。在陌生空间里朝目标穿行、从杂乱背景中挑出物体,或是预判并配合其他行为体的动作,这些能力没法在真实机器人上安全地大规模评测。而游戏恰恰是为了检验这些能力、耗费数百万小时打造出来的场景,还能并行运行、比实时更快、且没有任何风险。操控游戏的智能体,和替代人类操作软件的智能体之间,距离其实比想象中更近。
机器人模型的竞争重心,正从体量转向效率。7B权重已经公开,在消费级GPU上的运行速度也有了实测数据,没有大型集群的实验室如今也能站上同一条起跑线。从这里开始,比的就是谁能找到更好的微调方案。


评论