


摘要
- Anthropic 于 9 月 17 日把 Claude 优化开源生物学模型所产出的代码全部公开。
- 13 个结构预测模型在 Fast 模式下平均快 4.1 倍,14 个在输出完全一致的 Exact 模式下平均快 1.6 倍。
- 低内存的 Big 模式在一个 GPU 节点上准确预测了超过 1 万个 token 的分子机器。
Anthropic 让 Claude 把别人做的生物学模型跑得更快,不到四周,36 个开源模型实现被重写了一遍。公司于 9 月 17 日以 Science 博客与技术报告公开结果,并把优化代码全部作为开源发布。覆盖对象包括蛋白质结构预测、蛋白质设计、基因组学与蛋白质语言模型在内的 30 多个模型,公告称平均快了 4 倍左右。
要读懂这些数字,先得把模式分开。每个包都沿用原有权重,最多提供三种模式:把输出按位完全复现的 Exact、让出一点数值精度换取速度的 Fast,以及减少内存占用以容纳更大输入的 Big。技术报告称,在 NVIDIA H100 上,Exact 模式让 14 个结构预测模型的前向传播平均快 1.6 倍,Fast 模式让具备该模式的 13 个模型平均快 4.1 倍,Big 模式平均快 3.4 倍。
速度是从三角运算里挤出来的。AlphaFold3、OpenFold3、Boltz-2 这类最新结构预测模型,把运行时间与内存的相当一部分花在三角注意力与三角乘法上。它们处理的是三个 token 组成的三元组,成本随 token 数呈立方增长:规模翻一倍,时间与内存变成八倍,翻三倍则变成二十七倍。Claude 针对这一处做出了 GPU 内核集合 FlashPairformer v1,报告称在多数模型使用的配对宽度 128 上,其三角注意力比业界标准内核平均快 2.7 倍。
公共内核之上还叠了逐模型的具体改动:把原代码反复计算的中间值缓存下来,把输出恒定的分支折叠成常量,捕获 CUDA 图,并做内核融合。结构预测模型的 Fast 模式提速从 OpenDDE 的 2.3 倍到 Chai-1 的 6.4 倍不等,基因组学与蛋白质语言模型在 Exact 模式下获得 1.2 倍到 5.0 倍。
变快的代码有没有改变答案,是另外测的。在覆盖 13 种模型配置、汇总 1,925 个模型与靶标配对的基准上,被判定为可接受的界面比例在默认设置下为 54.8%,Exact 为 55.0%,Fast 为 54.5%,Big 为 54.2%。三种模式的变动幅度分别为 0.2 个百分点、负 0.4 个百分点、负 0.6 个百分点,全部在一个百分点以内,且与零无法区分,报告如此说明。界面以 DockQ 分数 0.23 以上算作可接受。
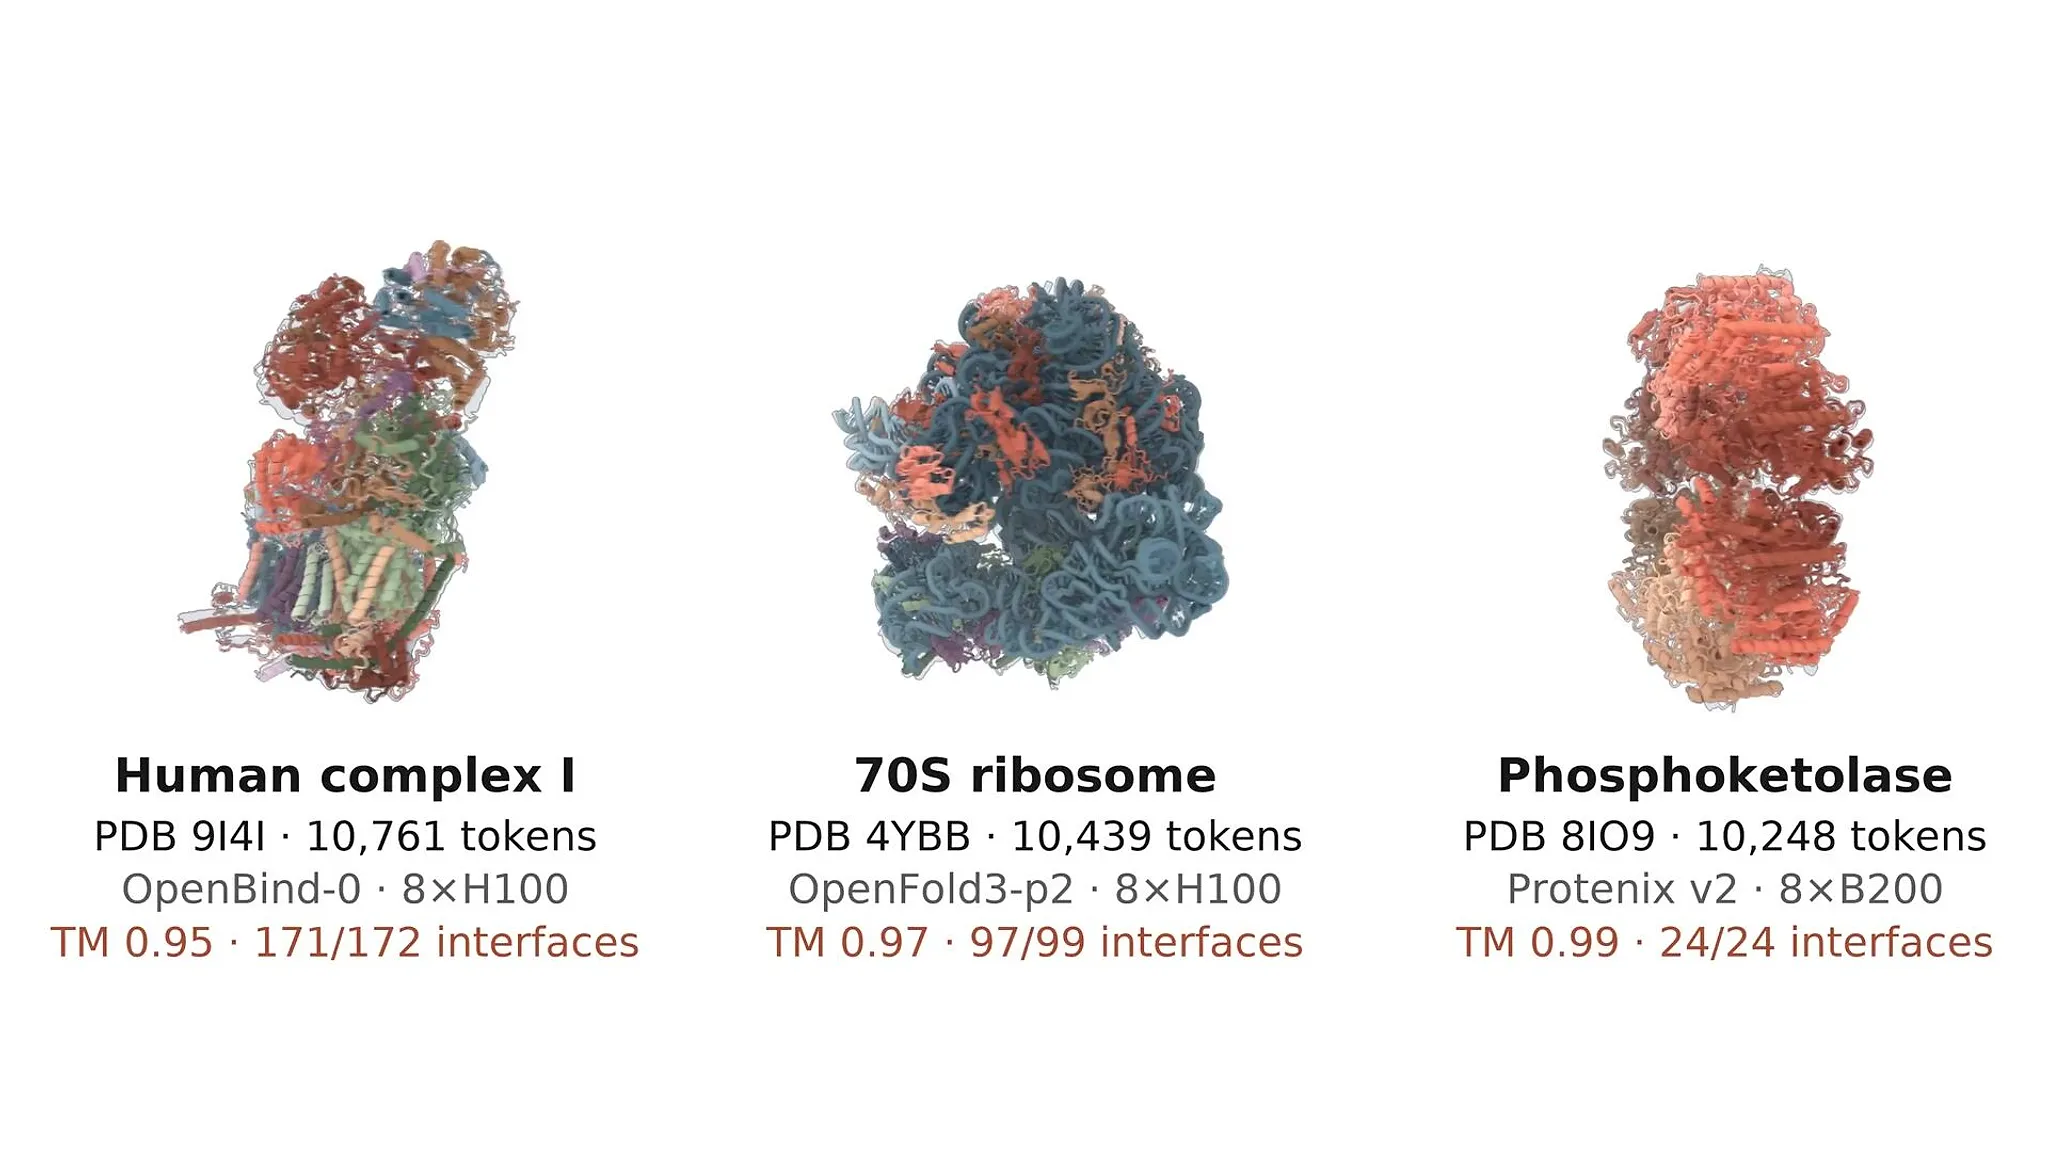
更醒目的是内存这一侧。细胞内的活由巨型分子机器承担:合成蛋白质的核糖体、为细胞供能的呼吸复合体、帮助其他蛋白质折叠的伴侣蛋白。预测这种尺寸的结构,过去一般需要多个 GPU 节点。Claude 做出的低内存 Big 模式,在一个 GPU 节点上就准确折叠出了超过 1 万个 token 的系统。人类线粒体复合体 I、TRiC 伴侣蛋白复合体、蛋白酶体与细菌 70S 核糖体都与实验测定的结构贴合,报告称 TM 分数介于 0.92 到 0.997 之间。AlphaFold3 论文拿来展示准确预测的 40S 核糖体为 7,663 个 token,而沿用该架构的模型训练所用的切片最多只有 768 个 token。
同一批实验的另一端,失败也以数字留了下来。用八张 B300 组成的节点跑病毒衣壳与蛋白质隔室,规模从 3.1 万个残基到 70,320 个残基,七次运行全部算完,但每一次的预测结构都塌缩成直径约为真实组装体四分之一的致密球体,有评分的 TM 分数在 0.08 到 0.14 之间。报告指出这些组装体比 AlphaFold3 最大的训练切片大 40 到 90 倍,因而判断这是泛化失败。被拓宽的是能够计算的尺寸,而不是模型学过的范围。
设计一侧的结果最能说明这次优化的价值。METAL 曾报道Claude 在 24 小时内自主设计的 12 个蛋白质中有一半在实验室结合成功;当时在同样的 24 小时里,每个靶标最多花费 1 万美元,按目录价约合 2,500 个 NVIDIA H100 GPU 小时,还动用了 1.6 万词的提示词与子代理。这一次,单个 Claude 模型只拿到一张 H200 和 24 小时运行时间、约 1,100 词的提示词与一份工具说明,没有子代理,也没有人工引导。
针对同样的 16 个靶标分别运行 Mythos 5.1、Mythos 5 与 Opus 5 后,报告称 24 小时后设计分数中位数为 Opus 5 的 0.785、Mythos 5.1 的 0.781、Mythos 5 的 0.739,而此前的活动为 0.749。最好的设计分别为 0.833、0.825、0.813,此前为 0.817。所用 GPU 时间为 24 个 H200 小时,约为此前的百分之一,公告称 GPU 与 token 合计约 150 美元即可达到此前活动的计算表现。打分所用的 ipSAE 是已知能预测实验室结合的计算指标,而这些设计尚未经过实验验证;METAL 曾报道过 AI 设计的蛋白质在预测与实验之间出现分歧的案例。
对打算拿代码来用的人来说,发布条款很关键。仓库中为每个上游工具各配一个可直接嵌入的优化套件,共 36 个,原始代码采用 Apache License 2.0。这些套件共用 off、exact、fast、big 的同一套词汇,基准配置是 Linux x86-64 上的 NVIDIA H100 80GB,部分套件还附带 A100、H200、B200 与 B300 配置。每次运行都会打印一行,标明启用了哪种优化;若该机器无法启用某模式,则打印 NOT ACTIVE 并以退出码 3 停止。这是为了防止悄无声息地退回原始实现而特意设下的。
仓库自称是不做维护的参考发布。上游版本被固定并按原样提供,不接受拉取请求,也没有跟进上游项目的计划。由于采用 Apache 2.0,有需要的一方可以自行分叉维护。METAL 查看的技术报告共 139 页,作者包括 Anthropic 的 Richard Shuai、Rohil Badkundri、Vincent Fan,Biohub 的 Kilian Fatras,以及哥伦比亚大学的 Lukas Jarosch。
这项工作是怎么推进的,摘要里有一句话写明。通讯作者、Anthropic 的 Amir Shanehsazzadeh 与共同作者写道:“在两位有生物分子建模经验、但没有推理优化或内核工程经验的科学家监督下,Claude 在不到四周的时间里产出了覆盖 30 多个开源模型的 36 个模型实现的优化包。”Anthropic 在公告中表示:“我们的结果表明,前沿 AI 模型将帮助这一领域的其他人更快、更轻松地构建科学工具。”
同一天,Anthropic 还与 Adaptyv Bio 联合举办蛋白质设计竞赛。双方共同选出五个处于当前能力边界的问题,包括跨物种交叉反应性、pH 敏感性、多肽与 MHC 特异性,以及 GPCR 这类困难靶标。最高 100 万美元的 Claude 额度与最高 25 万美元的 Modal 算力额度已投入,Twist Bioscience 提供 DNA,社区提交的 5,000 份以上设计将接受实验验证。据报道,参赛者保留设计的所有权,包括阴性结果在内的实验结果将全部公开,并且没有现金奖金。
用工程师的眼光看,这次公告里最大的数字不是 4.1 倍,而是四周。这类优化通常要有经验的工程团队为每个模型投入数周,而且做出来的工作也很难迁移到别的模型上。这一次,两位没有内核经验的监督者加上一个模型,把这件事在 36 个实现上做完了,留下的是可以打开查看的内核与基准配置。剩下的验证在实验室。计算分数再高,结合仍要在试管里确认,而那个答案要等到竞赛验证结束的 11 月底才会出来。

评论