


摘要
- NVIDIA介绍了World Action Model(WAM)概念,该模型以视频世界模型为基础,而非视觉-语言模型(VLM)
- 开放模型Cosmos 3采用Mixture-of-Transformers架构,学习了数亿条图像、视频和动作数据,被作为WAM的基础提出
- 据介绍,WAM先学习物理动力学,从而增强了对新任务、新机器人、新环境的零样本迁移性能
NVIDIA提出了World Action Model(WAM),作为机器人策略的新基础。此前指出,现有的视觉-语言-动作(VLA)模型是在预训练的视觉-语言模型(VLM)基础上添加动作模块的方式,虽然擅长描述场景,但在预测场景将如何变化的动力学建模方面较为薄弱。
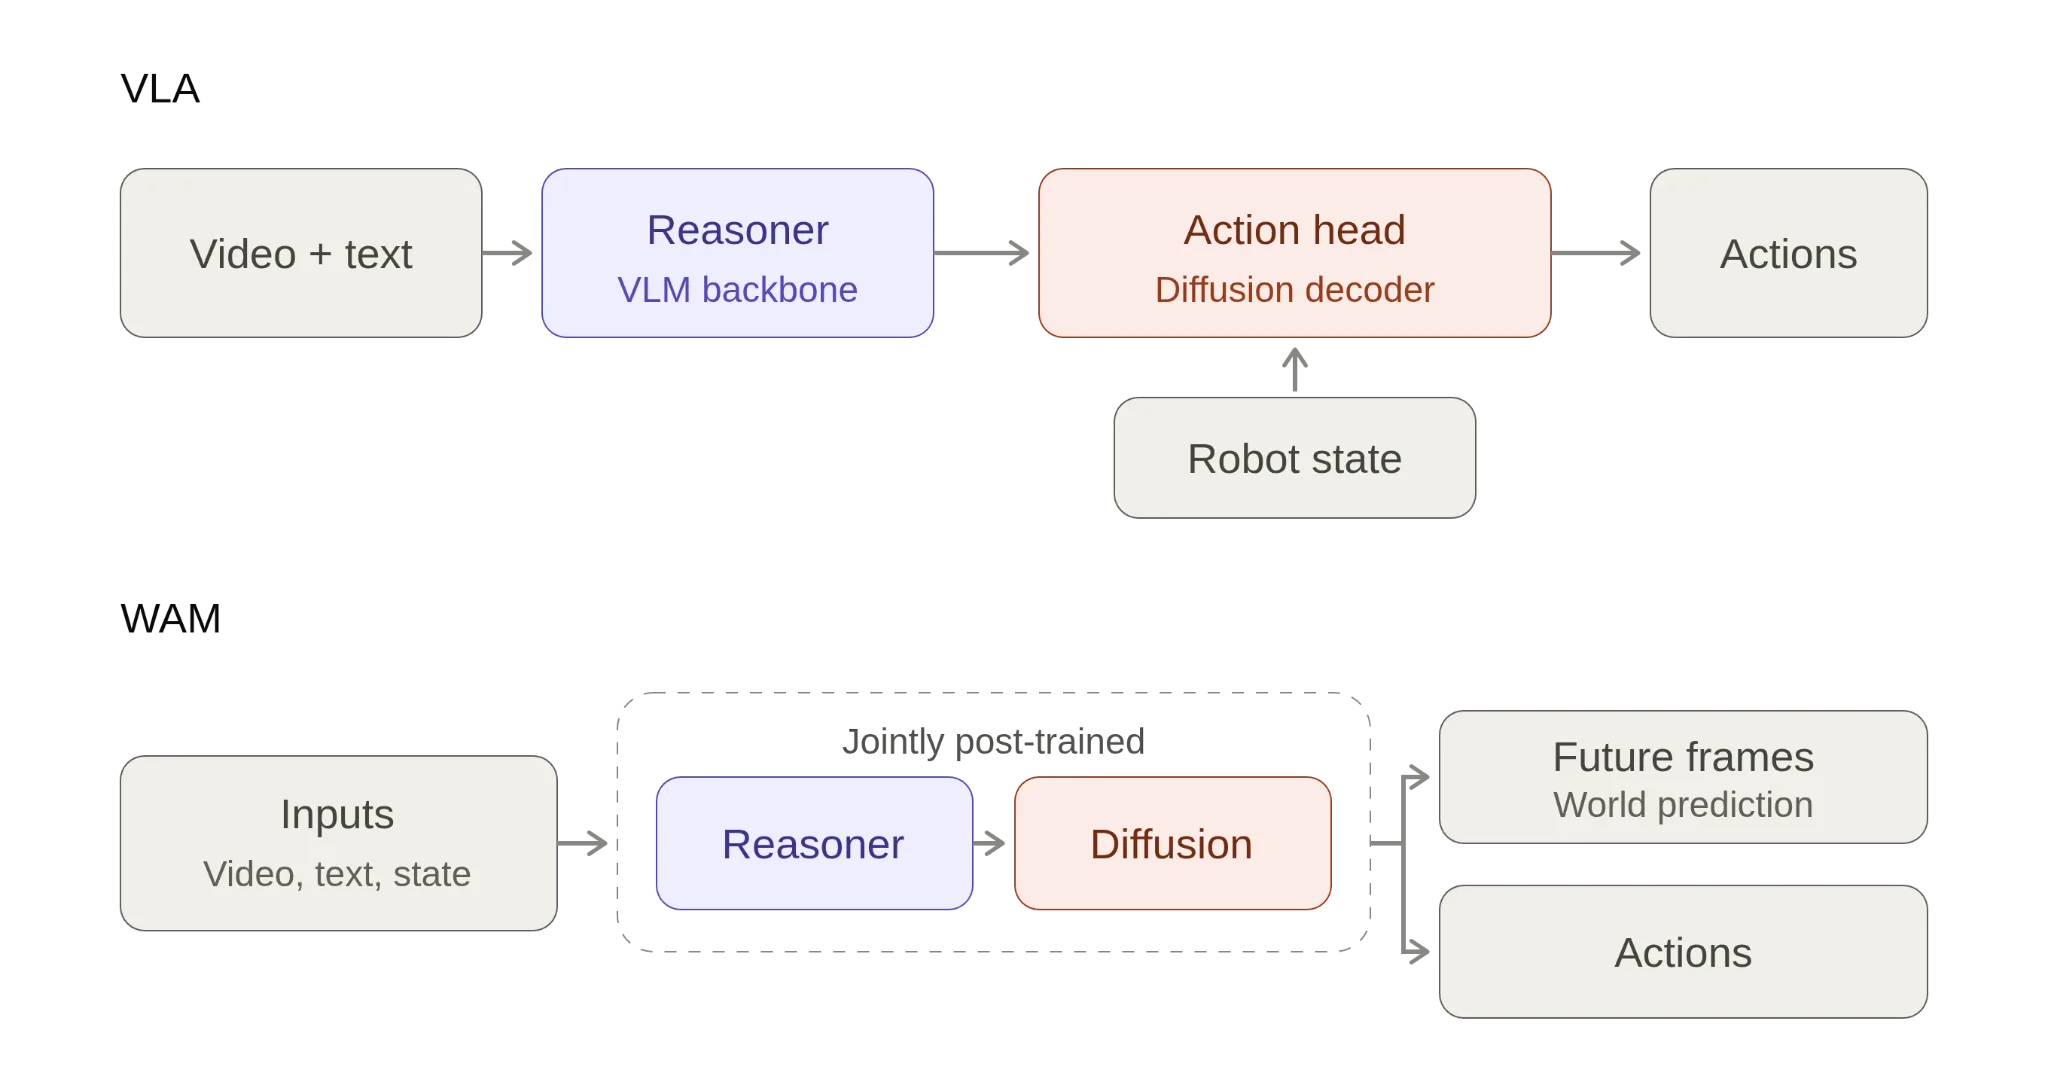
WAM将这一语言骨干替换为视频世界模型,从而预先学习杯子被抓取时如何变形、毛巾如何被折叠等物理变化。NVIDIA的研究论文《World Action Models are Zero-shot Policies》指出,同时预测视频和动作的方式,能提供VLA难以具备的特性,即从多样化数据中学习的能力。
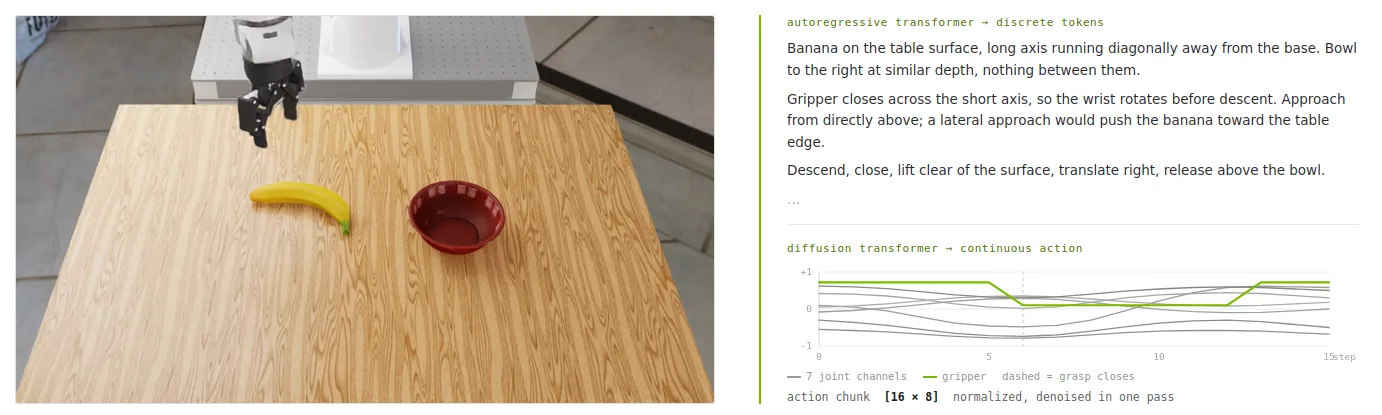
作为这一方法的基础,提出了开放模型Cosmos 3。Cosmos 3采用Mixture-of-Transformers架构,并基于包含数亿条图像、视频、动作样本的大规模多模态数据集进行训练。NVIDIA表示,Cosmos 3支持从高性能工作站服务到利用Jetson硬件的实时设备端推理等多级部署,并大幅减少了适应各种机器人形态时所需的任务特定数据量。


评论