


摘要
- 谷歌研究院发布了新一代基础模型TimesFM-3,它可以同时输入多条时间序列来预测未来走势。
- 该模型拥有3.3亿参数,在超过一万亿条时间序列数据上完成预训练,并在Gift-Eval、FEV-Bench、Time三大基准测试中全部拿下第一。
- 模型目前已可在GitHub和Hugging Face上下载,与BigQuery AI.FORECAST的集成预计将在未来几周内上线。
 为什么需要多变量预测
谷歌研究院在GitHub和Hugging Face的TimesFM-3模型页面上发布了多变量时间序列预测基础模型TimesFM-3。这款模型能够同时输入多条数据流并一次性给出未来预测值,主要针对零售、金融、医疗等实际业务场景中的时间序列预测任务而设计。


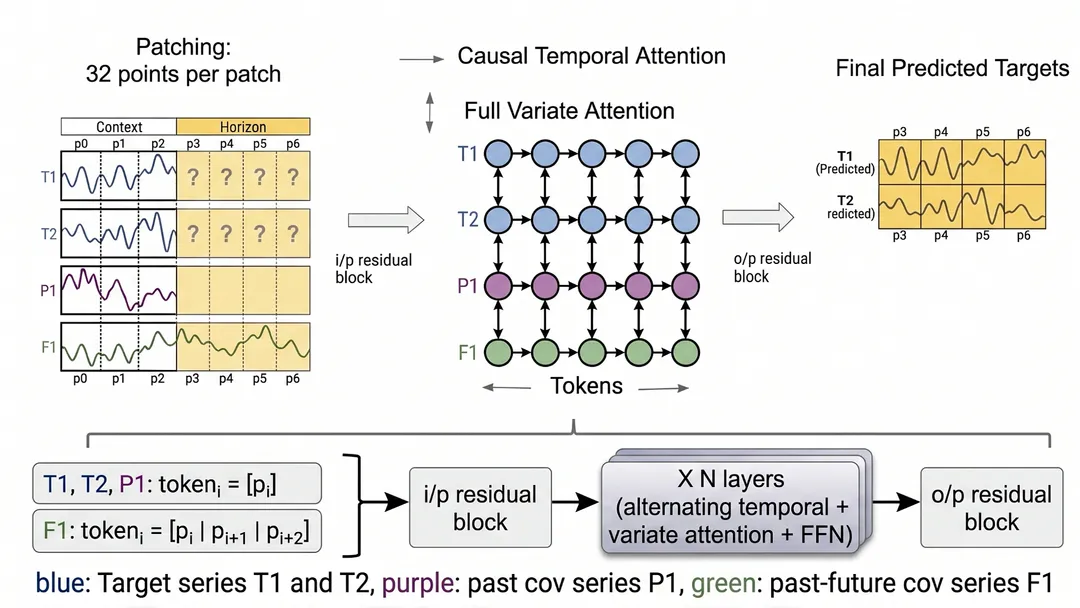
具体来说,此前的AI时间序列预测模型大多只盯着销量或访客数这一条数据流来预测未来,但实际门店经营中,往往还需要把促销日程、关联商品销量这类"未来已经确定"的信息一并纳入,才能得出更准确的预测。TimesFM-3的设计思路正是让模型能同时接收多条这样的数据,并计算它们之间的相互影响。
现实中的问题,比如销量或访客数,往往会同时受到关联商品销量、促销安排、天气预报等多种信息的影响,而单变量模型完全没有办法把这些信号纳入考量。
以冰淇淋销量为例看差距
谷歌研究院举了一个冰淇淋销量预测的例子来说明这个问题。只看历史销售记录的传统单变量模型,只会把过去的每周规律原样延伸到未来,却察觉不到某天即将开展的促销活动。TimesFM-3则把促销日程作为"未来已知信号"(past-future covariate)一并输入模型,从历史数据中学习促销与销量上涨之间的关系,再把这种关系套用到未来的促销日期上。谷歌研究院表示,最终模型预测每逢促销日,销量将上涨约20%。
3.3亿参数,一次前向传播完成预测
TimesFM-3和此前的版本一样采用仅解码器(decoder-only)的Transformer架构,但会把32个时间步打包成一个patch,再让这些patch通过一个二维注意力结构,在时间轴和序列间关系轴上分别进行计算。
对于"过去-未来"协变量,模型采用了一种"前瞻"(look-ahead)策略,让每个token能同时关联当前patch和未来patch。预测方式也有所改变:此前的版本是逐个patch依次生成,会带来延迟和误差累积的问题。TimesFM-3基于一项采用Contiguous Patch Masking方法的研究,先把整个未来区间进行掩码处理,再通过一次前向传播同时填补所有预测值。模型在每个时间点都会给出对应10~90百分位的9个分位数,从而同步呈现预测结果的不确定性范围。

三项基准测试均排名第一
谷歌研究院在Gift-Eval基准、FEV-Bench、Time三个测试平台上对TimesFM-3进行了评估。与支持多变量的Chronos-2、Toto 2.0系列,以及上一代TimesFM-2.5相比,TimesFM-3在这三项基准测试中,无论是点预测还是概率预测指标,都在所有预训练基础模型中排名第一。
| 评估方式 | 测试基准 | 成绩 |
|---|---|---|
| 单变量模式(不使用协变量评估) | Gift-Eval, FEV-Bench, Time | 与其他基础模型持平或更优 |
| 多变量模式(使用协变量) | Gift-Eval, FEV-Bench, Time | 点预测与概率预测指标均排名第一 |
谷歌研究院表示,即便在单变量模式下——也就是不使用协变量信息、对每条时间序列单独评估的情况下——TimesFM-3的表现也与其他竞争模型持平甚至更优;而一旦切换到多变量模式,排名还会再进一步提升。
如何上手使用
从哪里开始 —— TimesFM-3的模型权重可在GitHub仓库和Hugging Face的TimesFM-3模型页面下载。
使用步骤
- 从Hugging Face或GitHub下载TimesFM-3的PyTorch模型权重。
- 准备好要预测的目标序列(如销量),以及关联商品销量这类历史协变量,还有促销日程这类未来已知协变量。
- 将这些数据一并输入模型,无需多轮迭代,一次前向传播即可得到整个预测区间以及9个分位数结果。
谁可以使用 —— 直接调用代码加载模型这种方式,比较适合有开发能力的团队。如果不具备机器学习专业知识,也想体验时间序列预测,现在就可以通过BigQuery的AI.FORECAST命令,使用上一代模型TimesFM-2.5进行单变量预测。
可以尝试哪些场景 —— 零售连锁企业可以把促销日程和库存数据一并输入,提前预估折扣期间的销量激增;制造业则可以把设备运转计划和原材料入库时间表作为协变量,预测产量变化。在可观测性(observability)领域,还可以同时输入多项服务器指标,观察某一指标出现异常信号时对其他指标产生的连带影响。
编辑视角
用一个无需针对特定领域微调的预训练模型,去预测各种不同领域的时间序列——这原本是图像和语言模型的思路,而两年之后,谷歌把这个思路从单变量扩展到了多变量,让它离真实业务场景更近了一步。这股趋势也让TimesFM-3不得不在Salesforce的Gift-Eval基准上,与Chronos-2、Toto 2.0等其他多变量模型站在同一把尺子下较量。
把这类规模的时间序列模型真正用到业务里,结论往往大同小异——单变量模型擅长捕捉季节性、每周规律这类会重复出现的走势,但一旦遇上促销、假期这种"这次情况不一样"的场景,准确率就会明显下滑。TimesFM-3选择支持协变量输入的架构,可以说正是冲着这个痛点去的。
对国内的零售、制造企业来说,值得关注的一点是这款模型已经开源,不需要另签合同就能拿自己的数据先验证一遍。不过考虑到BigQuery的集成目前还没有扩展到TimesFM-3,如果团队希望在云控制台里一条命令直接调用,短期内更现实的做法是先用TimesFM-2.5做实验,同时把数据管道准备好。
一旦BigQuery的AI.FORECAST命令在未来几周内开始支持TimesFM-3,即便是不直接写代码的数据分析团队,也能更轻松地试用多变量预测功能了。
信息来源
- Google Research Blog — TimesFM-3: A zero-shot foundation model for multivariate forecasting →
- Google Research — Introducing TimesFM-3, a state-of-the-art time series foundation model that enables accurate multivariate time series forecasting in a single forward pass, significantly outperforming other forecasting models across major benchmarks. →
- MarkTechPost — Google AI Releases TimesFM-3: A 330M Parameter Zero-Shot Foundation Model For Multivariate Time Series Forecasting →


评论