


摘要
- 谷歌于9月23日发布 Gemini 3.8 Flash TTS 和 Flash-Lite TTS 两款模型。
- 预设声音从30个扩展到2,000多个的声音库,用户可以用文字设计新声音,或用30秒样本复刻声音。
- Flash TTS 在 Hume AI 声音设计基准中以71.4分排名第一,输入上限为8K token 文本。
谷歌于9月23日发布两款把文本转换为语音的 Gemini 3.8 TTS 模型。面向创作的 Gemini 3.8 Flash TTS 仅凭自然语言描述就能设计新声音,面向规模化的 Gemini 3.8 Flash-Lite TTS 则承担配音、语音智能体等高负载任务。两款模型当天起在 Gemini API 和 Google AI Studio 开始推出。
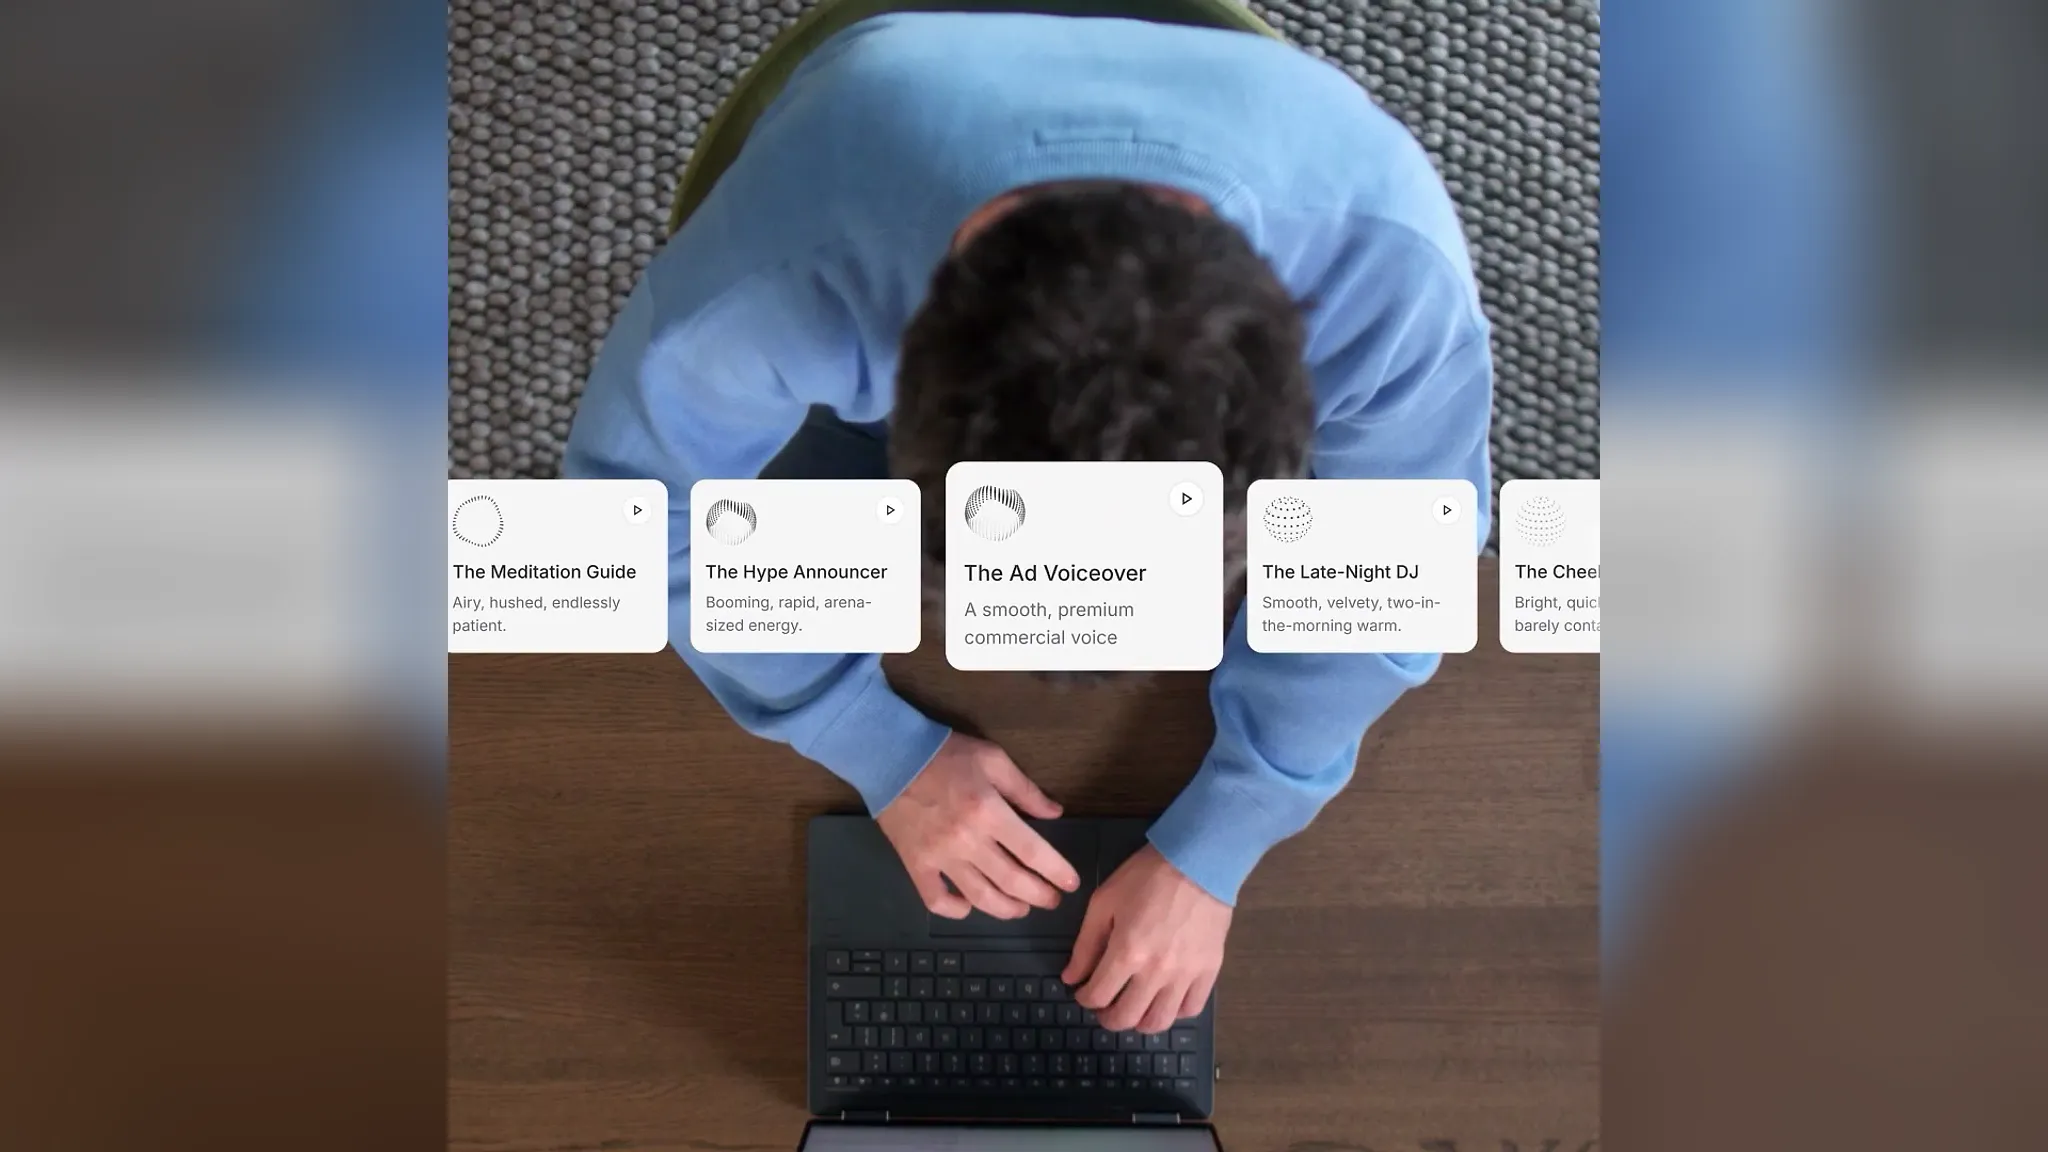
谷歌的说法可以归结为一句话。撰写发布文的集团产品经理 Leland Rechis 与研究科学总监 Alan Cowen 表示,这些模型正在"把语音生成从静态预设变成动态的创作工作室"。具体来说,就是从在30个默认声音中挑选,扩展到2,000多个可直接用于制作的声音库,外加用户自建的声音。声音库包含墨西哥西班牙语、魁北克法语、苏格兰英语等地区变体。
制作声音有三条路径。第一种是用文字写出角色、口音和音色,从零构建声音,支持100多种语言和方言。第二种是用30秒音频样本复刻自己的声音,或有权使用的声音。第三种是声音混音,可用提示词调整声音库中声音的音色、音高、语速和口音,目前只标注为即将推出。创建的声音可以保存,并在多个项目中以相同音色持续使用。
对工程师而言,值得注意的是导演语法。用户可以为剧本每一行写舞台指示,也可以让 Gemini 读取剧本线索来决定语气。笑声、叹气、倒吸气用尖括号标签插入,附和声则用竖线包裹的短词插入。模型还原生支持用一个剧本调度双人对话,两个声音不会混在一起。谷歌称,即使在连续数小时的音频中,说话人音色也几乎不漂移。这一设计瞄准播客和有声书。
规格写在模型卡中。根据 Google DeepMind 的 Gemini 3.8 Audio 模型卡,两款 TTS 模型基于 Gemini 3 Pro,输入最多8K token 文本,输出最多64K token 音频。同一张卡中的 Gemini 3.8 Live 可接收最多128K 的音频、图像、视频和文本,而 TTS 只接收文本输入。知识截止时间为2025年1月,已知局限包括幻觉以及偶发的延迟或超时。
性能依据来自外部评测榜单。据谷歌介绍,Gemini 3.8 Flash TTS 在 Hume AI 声音设计基准中以71.4分获综合第一,口音建模以60.8分排名第一。在同一公司的综合质量指数中,Flash TTS 排第一,Flash-Lite TTS 排第二。谷歌表示,在 Voice Arena 的盲测偏好评估中,两款模型在日语、巴西葡萄牙语、越南语、现代标准阿拉伯语、墨西哥西班牙语和印地语中位居前列。公司称,与上一代 Gemini 3.1 Flash TTS 相比,长内容和双人剧本控制明显改进。
声音复刻设有门槛。Rechis 和 Cowen 在发布文中写道:"在创建声音之前,用户必须提交与参考说话人一致的声音主人口头同意录音。"所有生成的音频都嵌入人耳无法察觉的 SynthID 水印,复刻功能还附带 C2PA 凭证。据报道,AI Studio 的声音复刻在美国伊利诺伊州、得克萨斯州、欧洲经济区、英国、瑞士和印度无法使用。围绕生物特征数据和声音权利的监管,直接体现在了功能地图上。
METAL 查看的 Google DeepMind 59秒 X 宣传视频,展示了用文字点单声音、从三个候选中挑选、把一个说话人调得更低沉、放入双人场景,再经过简短的语音身份确认换成自己声音的流程。视频旁白称可直接使用的声音有一千多个,而发布文写的是2,000多个。该帖子发布不到一小时浏览量就超过1.8万次。
两款模型的分发渠道不同。Flash TTS 通过 Gemini API 和 AI Studio 面向开发者,通过 Gemini Notebook 面向普通用户;Flash-Lite TTS 则进入 Google Vids。面向企业的 Gemini Enterprise API 对两款模型都只标注为即将推出。开发者平台中,Agora、LiveKit、Pipecat、Vercel 通过 Gemini API 提供支持,Figma、HeyGen、Wondercraft 等6家合作伙伴正将其用于配音、本地化和语音智能体。
谷歌的语音产品线在9月迅速补齐。METAL 此前报道过谷歌于9月15日发布实时对话用的 Gemini 3.8 Live 和 Live Extended Thinking,这次两款 TTS 是紧随其后的发布。模型卡判断,两款 TTS 模型与 Gemini 3.7 Flash 相比没有有意义的新能力,不太可能达到其前沿安全框架中的追踪或关键能力等级。
从 TPM 的角度看,这次发布的核心在于语音从选择列表变成了用代码管理的资产。声音用提示词构建、保存,并以相同音色接入多个产品,表演指示则作为剧本标签进行版本管理。创作质量交给 Flash、规模交给 Flash-Lite 的组合,也直接对应流水线设计。尚待解决的是,在复刻功能被屏蔽的地区如何运营同一产品,以及企业 API 何时开放。


评论