


摘要
- ElevenLabs于9月28日发布了基于全新架构的语音模型Eleven v4,以及面向实时场景的Eleven v4 Turbo。
- Eleven v4登上Artificial Analysis语音排行榜第一名,在公司的盲测偏好测试中以65%至81%的比例胜过竞争模型。
- Turbo首段语音时间中位数约为150毫秒,两款模型均支持90多种语言和内联演绎标签。
ElevenLabs于9月28日发布了新语音模型Eleven v4及其低延迟版本Eleven v4 Turbo。公司称Eleven v4是"迄今为止情感最丰富的文本转语音模型",两款模型均支持90多种语言。Eleven v4在AI模型评测网站Artificial Analysis的语音排行榜上位居第一,两款模型自发布当天起即可在ElevenAgents、ElevenCreative和ElevenAPI中使用。
Eleven v4构建在全新的架构之上。ElevenLabs表示,该模型会像配音演员一样阅读剧本,从上下文中理解谁在说话、刚刚发生了什么、每一句台词应当如何落地,进而把握语气、节奏、情感和角色。公司称,在多人对话场景中,它生成的是说话者会回应前一句话的对白,而不是把分别生成的台词拼接在一起。
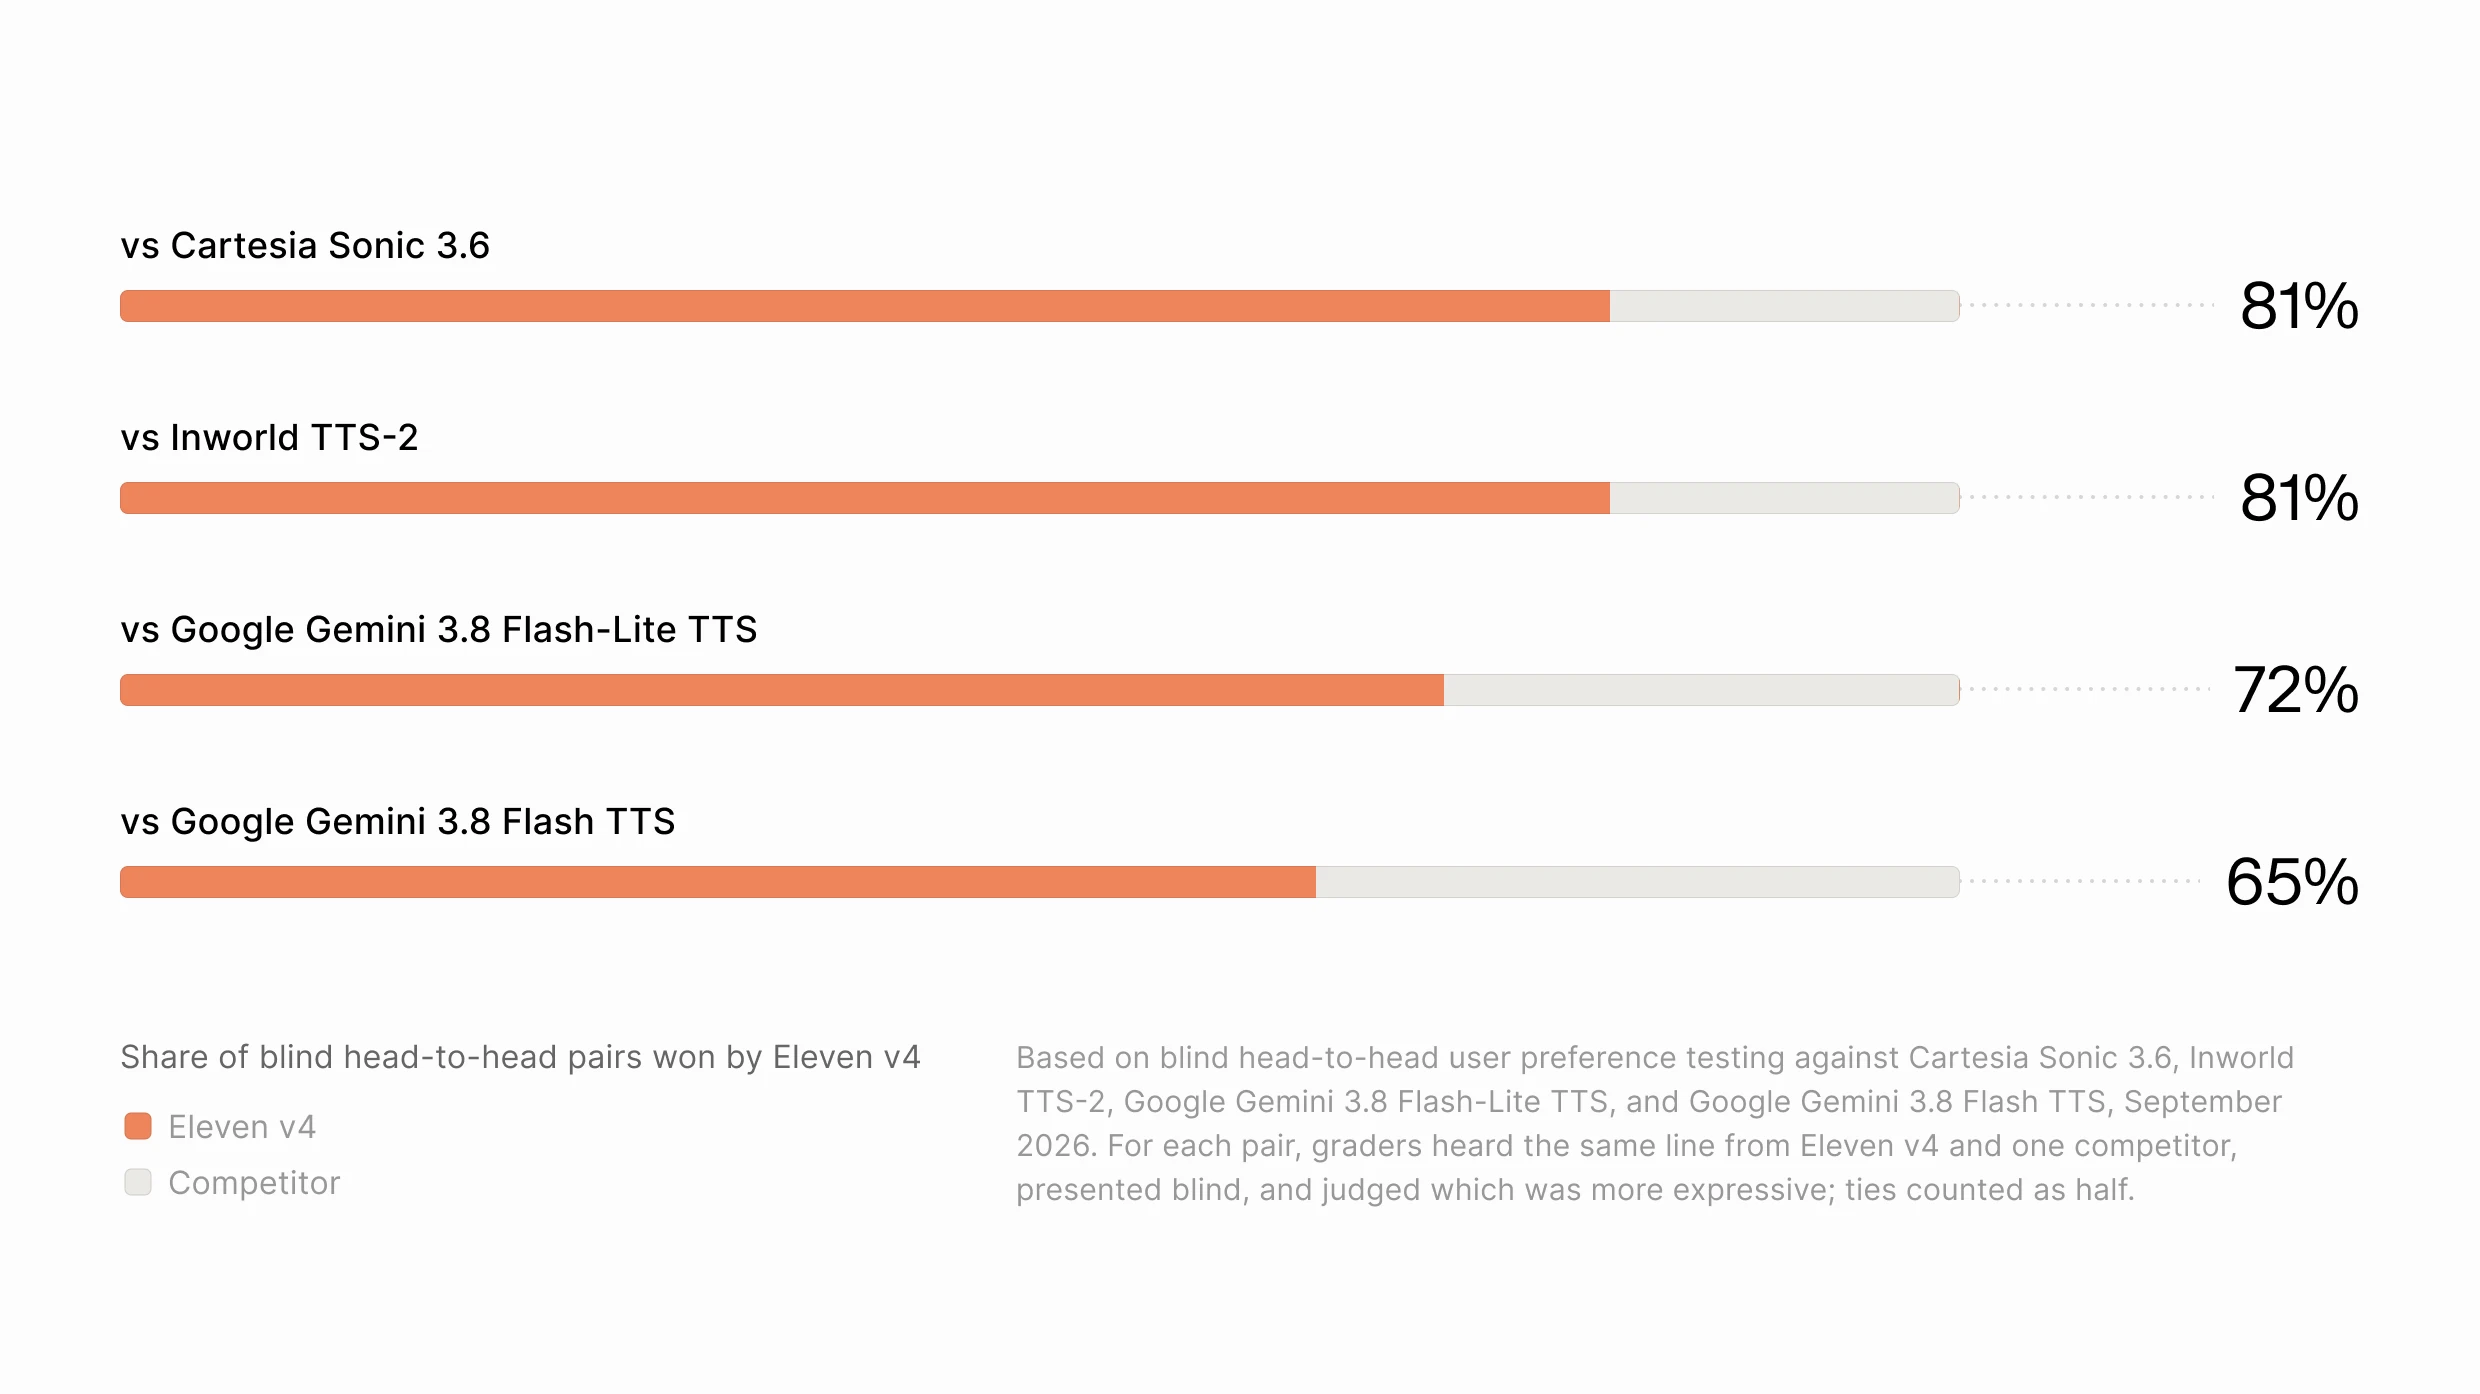
公司拿出了两组数字作为依据。在ElevenLabs于9月进行的一对一盲测偏好测试中,听众约有75%的比例选择了Eleven v4。按对手来看,它对Cartesia Sonic 3.6和Inworld TTS-2的胜率均为81%,对Google Gemini 3.8 Flash-Lite TTS为72%,对Gemini 3.8 Flash TTS为65%。据报道,Eleven v4在Artificial Analysis排行榜上以1674个样本获得了1319的Elo分数。
把演绎指示写进剧本是这一版本的核心。用户可以用自然语言描述一句台词该怎么说,也可以在剧本中插入[laughs]、[said angrily in French accent]、[light rain]、[phone buzzing]等内联标签,指定情感乃至音效。多个标签叠加使用时,模型会按顺序执行。官方产品页面称,v4比v3更稳定地遵循标签顺序,同时大幅改进了对国际音标(IPA)的支持,用户可借此设定人名和缩写的发音。METAL核实的2分36秒官方演示视频表明,片中的片场导演与演员对话、新闻主播报道鸽子谜案以及药房事先授权电话,都是仅凭提示词生成、未经剪辑的。
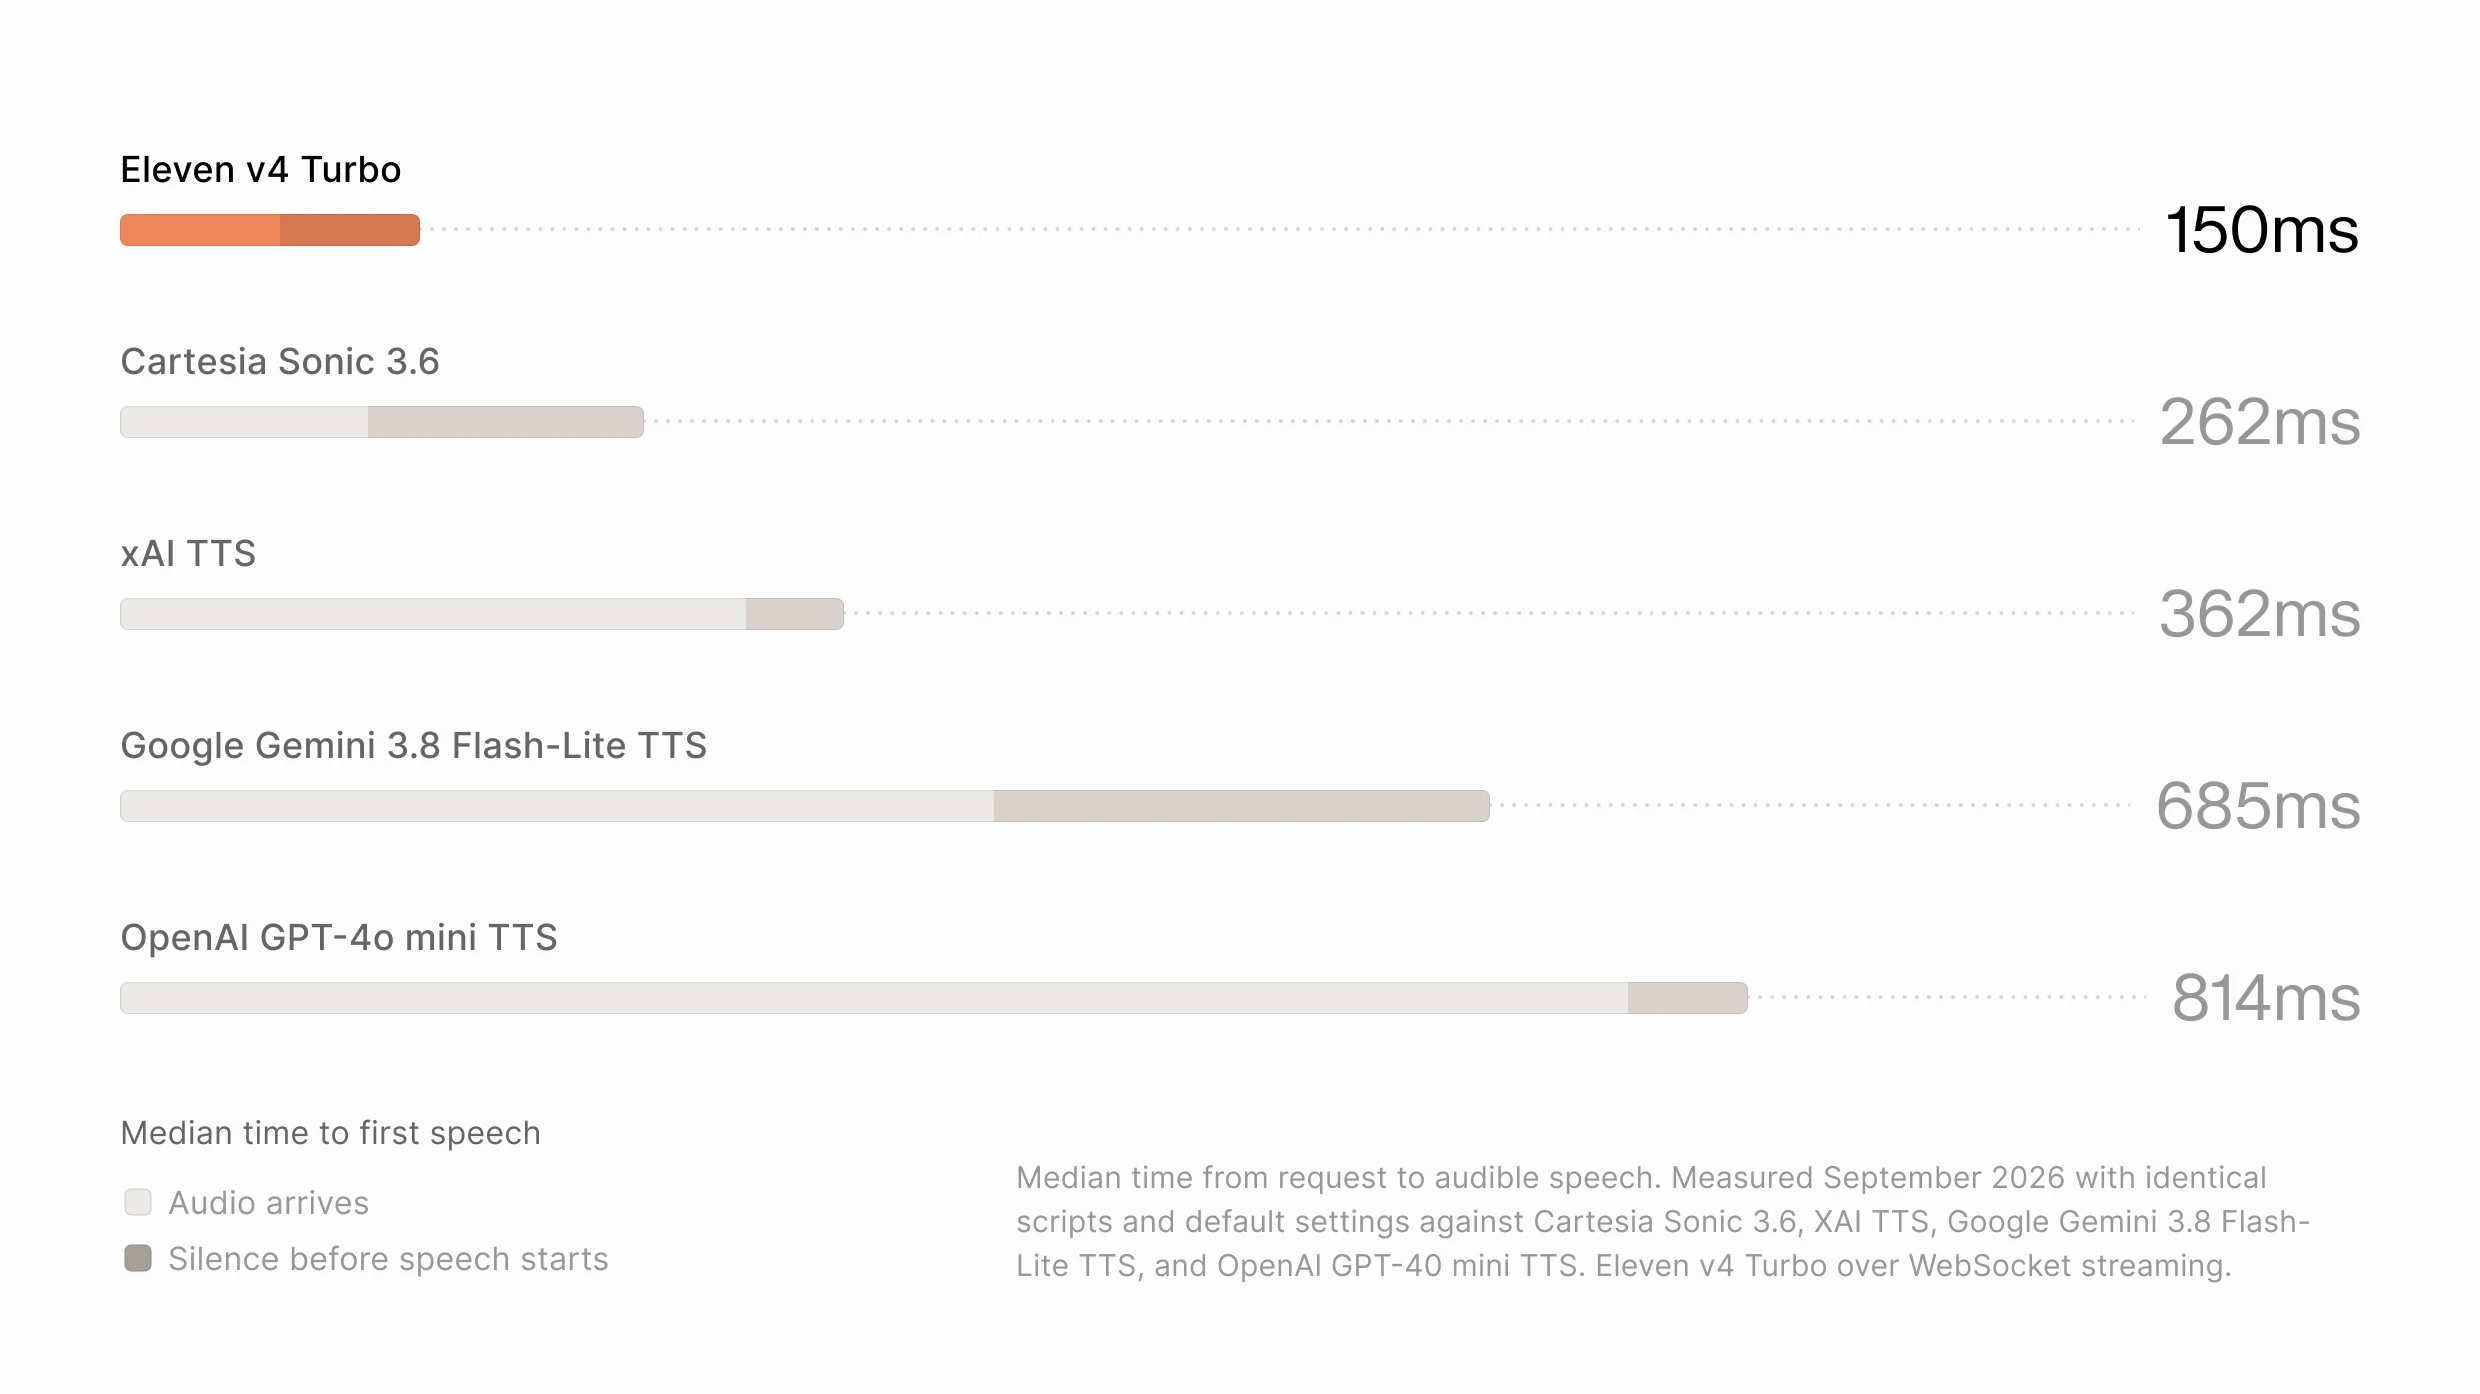
Eleven v4 Turbo是面向实时对话的模型。其推理延迟中位数约为100毫秒,从请求到听到声音的时间中位数约为150毫秒。在ElevenLabs使用相同脚本和默认设置进行的对比中,Cartesia Sonic 3.6用时262毫秒,xAI TTS为362毫秒,Google Gemini 3.8 Flash-Lite TTS为685毫秒,OpenAI GPT-4o mini TTS为814毫秒。公司表示,这一速度比两人交谈时的平均停顿还要快。Turbo支持双向流式传输,大语言模型生成答案的同时即可开始输出语音,并与ElevenLabs的智能体平台ElevenAgents作为一个系统共同优化。
发布公告中还收录了客户的反馈。Salesforce Agentforce Voice产品高级副总裁Ryan Peterson表示:"我们正看到Eleven v4 Turbo以更快、更自然的回应提高标准。"信贷产品公司Spring Financial的信用建设产品负责人Oscar Daniels评价说,Eleven v4 Turbo"是第一个兼顾速度与质量的模型","在自动化销售流程中,这是构建不再像实验的节点"。
语言范围也扩大了。据报道,上一代支持70种语言,v4增至90多种,质量提升最大的是日语、巴西葡萄牙语、普通话和粤语。用一种语言录制的声音在说另一种语言时,会保留原声特征,同时采用该语言母语者的口音。公司称即时语音克隆只需10秒音频即可复制声音,但据报道v4开发文档写明通常使用1至2分钟的样本。在v3中被移除的专业语音克隆重新获得支持,分多次生成长篇脚本时声音不走样的拼接功能也得到了改进。
从AI工程师的视角看,此次发布的核心在于从同一架构中分别释放表现力和速度的设计。ElevenLabs指出,高质量语音模型速度慢,迫使企业选择快速但单调的智能体。把同一技术拆分为用于创作的v4和用于实时的Turbo,并将智能体平台与模型作为一体进行调校,是公司与只卖模型的竞争对手划清界限的方式。语音库中1.75万多个声音可在两款模型中直接使用,也降低了切换成本。
业务重心也在朝这个方向移动。据报道,ElevenLabs超过55%的收入来自大企业,年化收入从年初的约3.3亿美元增至6亿美元以上。公司今年早些时候在红杉资本领投的一轮融资中获得5亿美元,估值110亿美元,员工人数已超过800人。据报道,联合创始人兼首席执行官Mati Staniszewski表示公司计划"在未来几年内"上市,但未承诺具体时间。METAL曾报道ElevenLabs正式发布实时对话语音模型v3 Conversational。
在Cartesia、Deepgram等初创公司以及谷歌、OpenAI等大公司纷纷推出富有表现力的语音模型之际,ElevenLabs以排行榜第一和150毫秒这两个数字作出回应。公司的主张是,它已经越过模仿人声的阶段,进入演绎剧本的阶段,而这一主张如今将在客服电话、有声书和游戏台词等真实场景中接受检验。
信息来源
- ElevenLabs — Eleven v4: Our most expressive text-to-speech AI model yet →
- ElevenLabs — Eleven v4 and Eleven v4 Turbo Text to Speech models →
- TechCrunch — ElevenLabs' new v4 speech model supports more expression control and 90 languages →
- RuntimeWire — ElevenLabs ships v4 voice models, ranked No. 1 by Artificial Analysis →


评论