


摘要
- Allen AI基于真实辅导环节数据,公开了AI辅导评估框架"TutorMoments"预览版
- 大语言模型默认表现出过度帮助的倾向,即使在提示中明确说明判断标准,也未能达到人类教师所展现的多样化策略水平
- 数据集、代码、模型回放结果均已开源,但目前仅限于美国中小学数学科目的早期预览阶段
AI辅导系统需要解决的核心难题
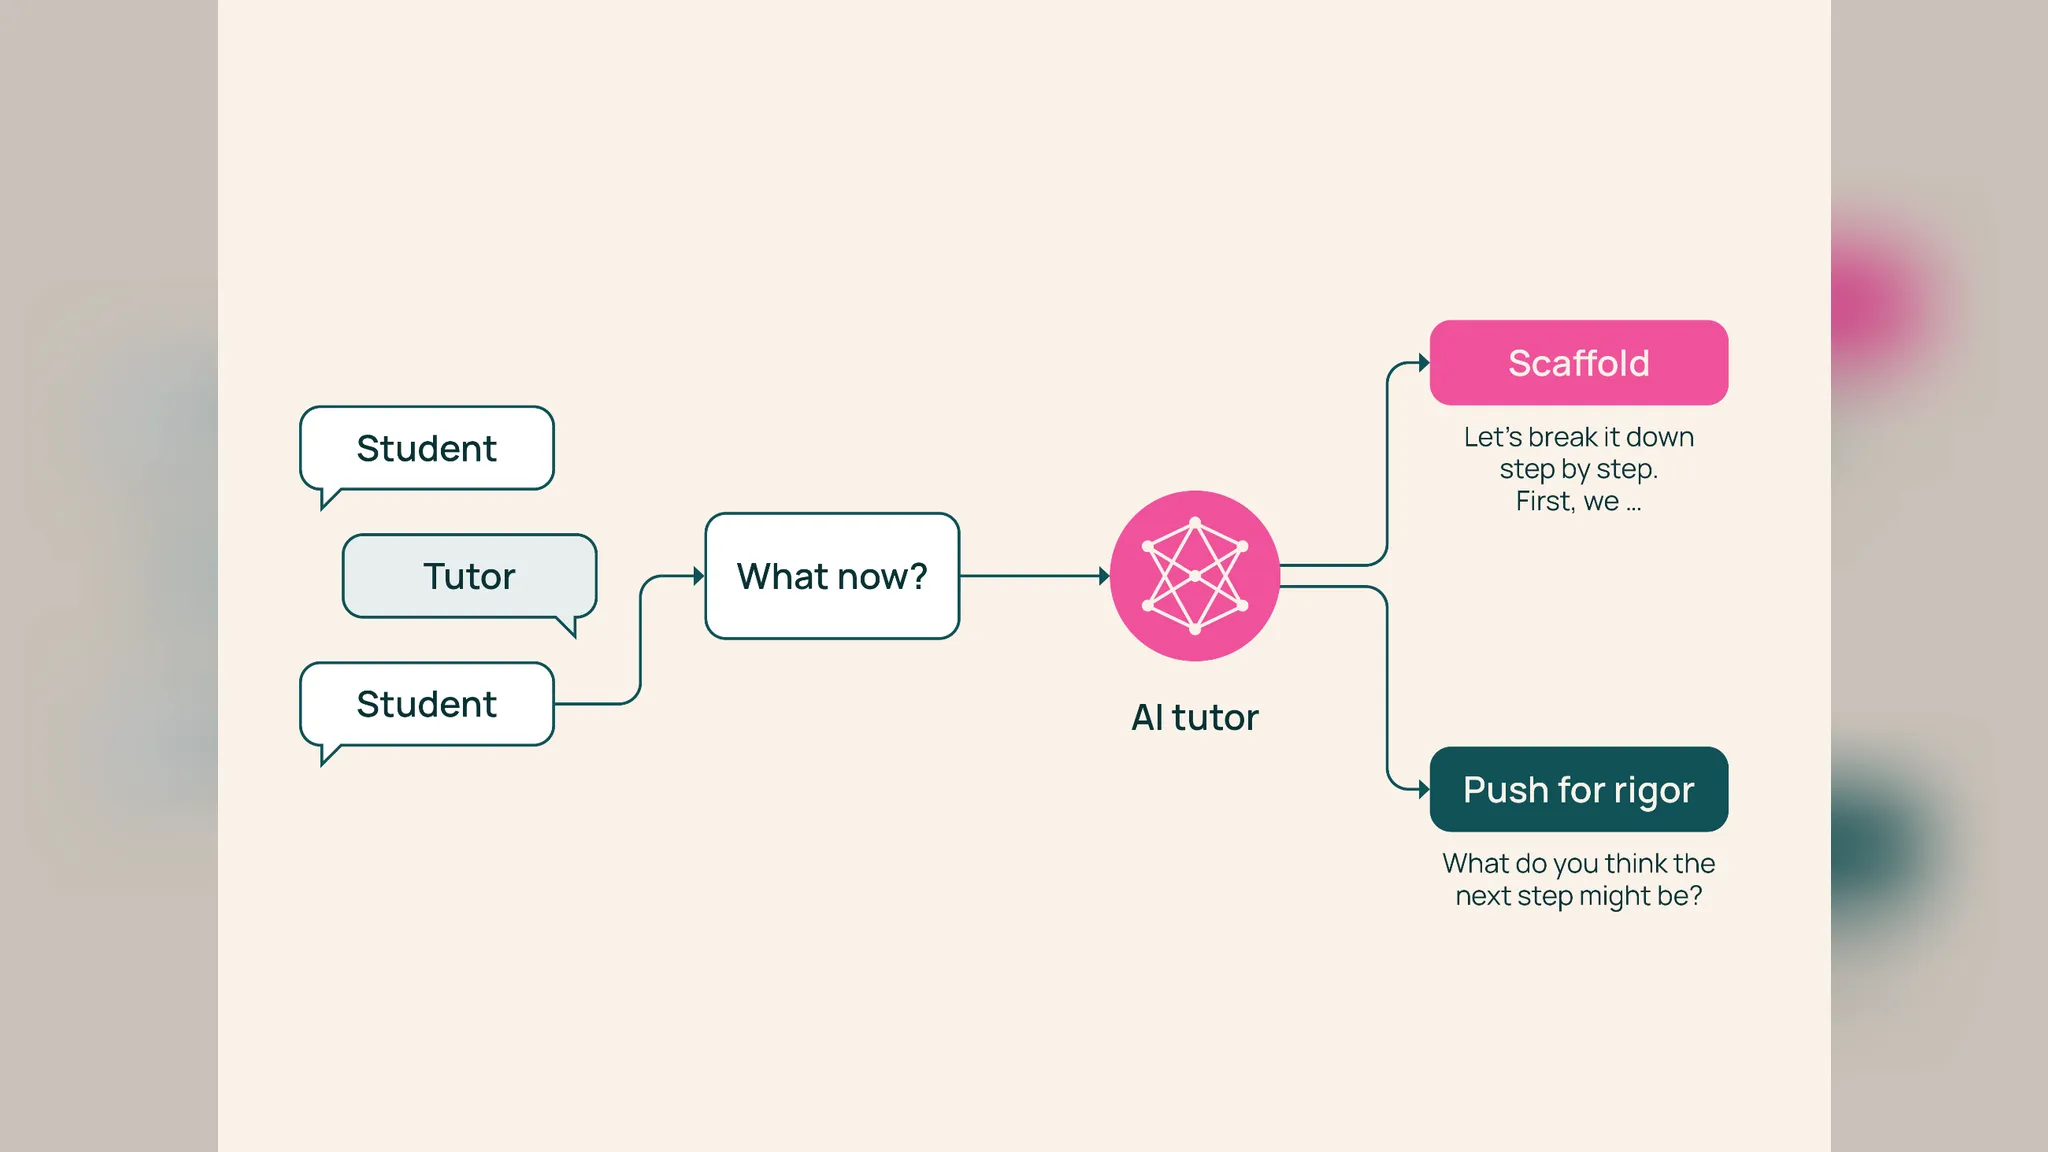
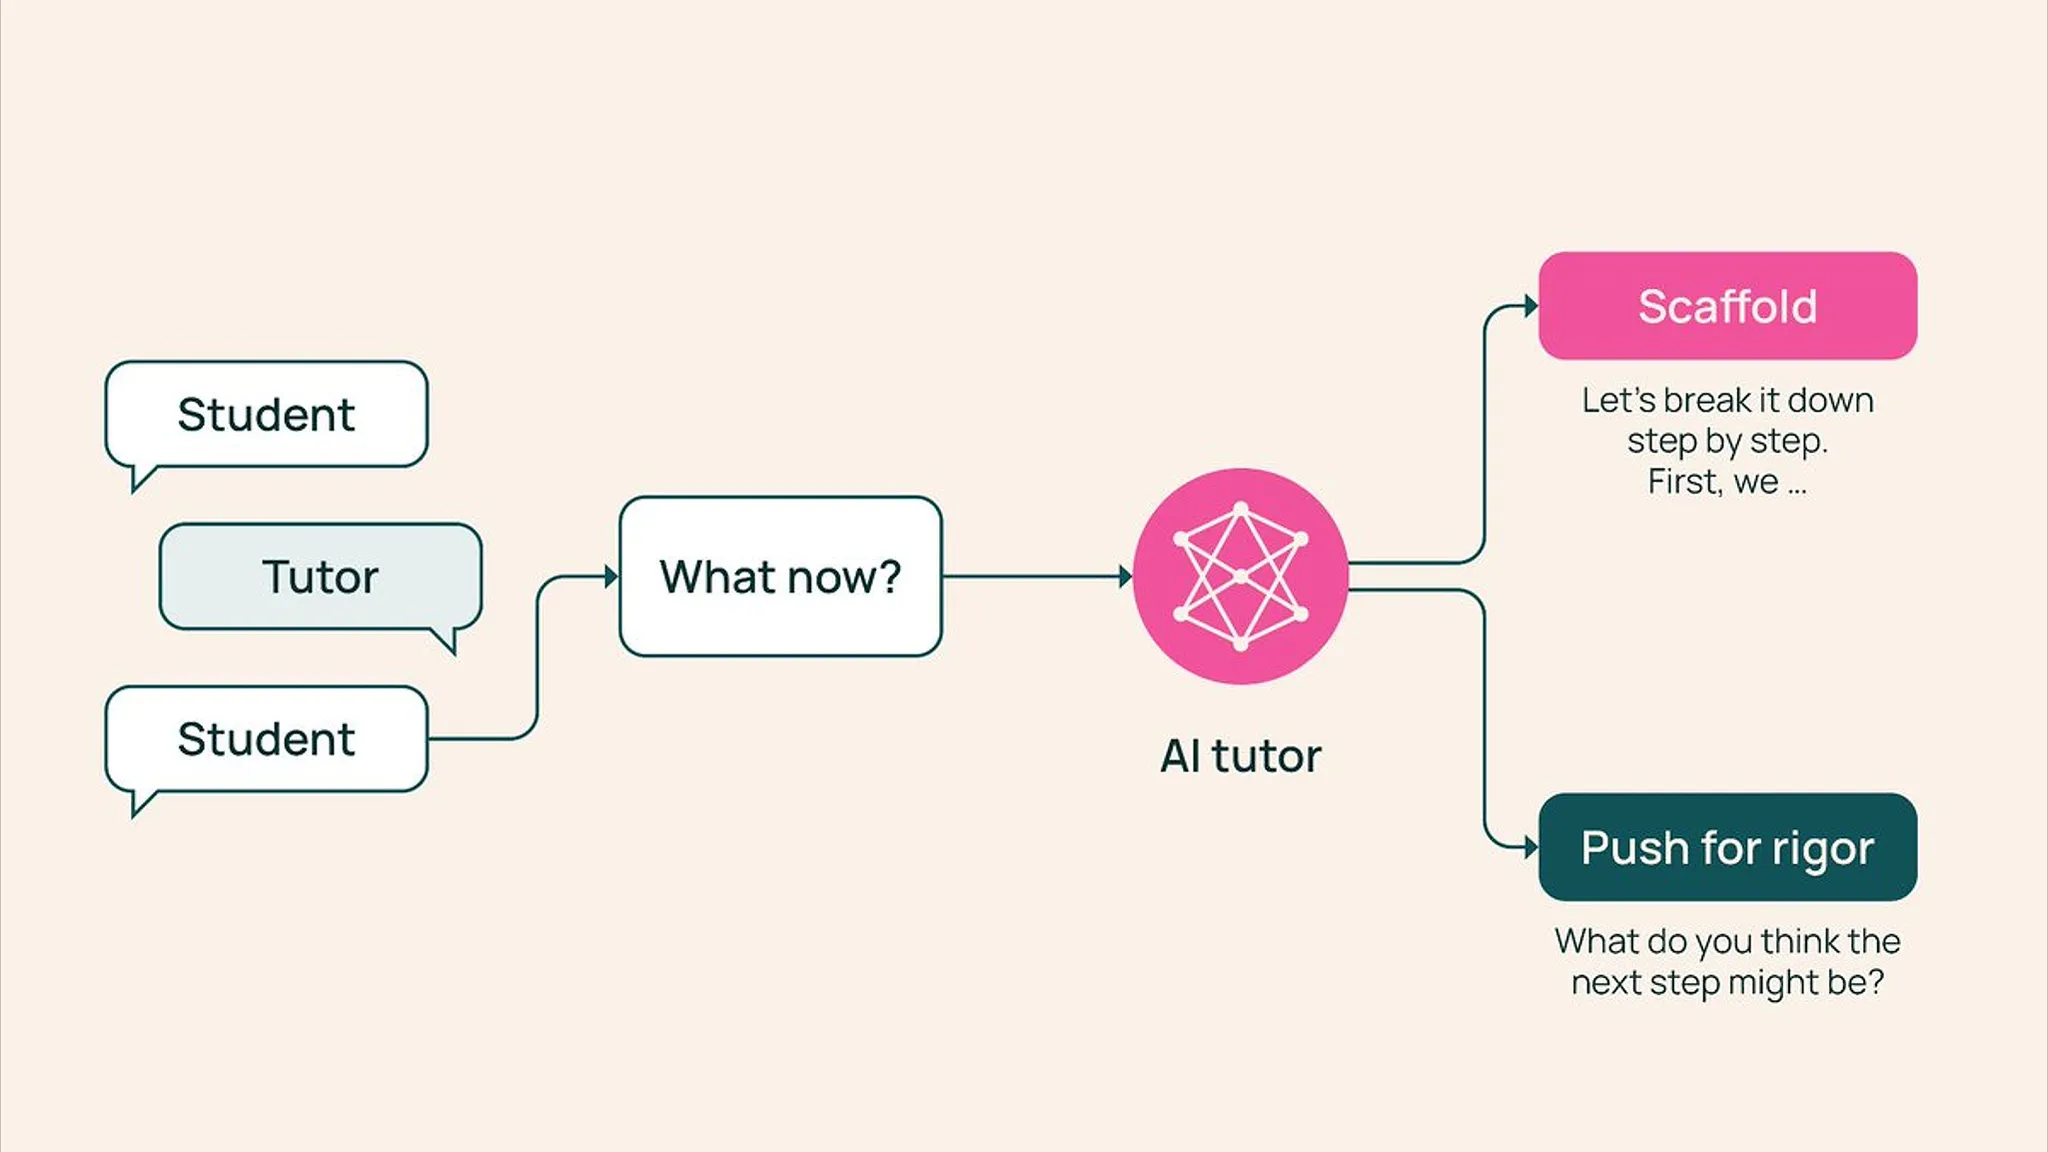
优秀的数学教师在学生卡壳时不会直接给出答案,而是会用"这道题你已经知道什么了?"这样的问题把思考的球重新踢回给学生,引导其自主思考。相反,如果学生已经充分理解,要求更深层次思考则更为有效。这种在"支持(scaffolding)"与"挑战(rigor)"之间取得平衡,正是辅导教学的核心,但语言模型在结构上很难做到这种平衡。
大语言模型是被训练成"乐于助人"的助手。解释概念、罗列步骤、引导得出答案是其默认行为。但在辅导场景中,这种行为可能会打断学生自主解题所需的"有效挣扎(productive struggle)"过程。正如学习研究长期以来强调的那样,正是这种挣扎过程才能加深理解。
TutorMoments框架结构
TutorMoments基于美国课外辅导项目中收集的真实一对一数学辅导环节构建。公开的预览数据集(TutorMoments-Preview)包含462个美国2至7年级学生的一对一数学辅导环节,其中包含27名美国在职教师标注者标记的1500多个关键判断时刻,以及数千条自由文本注释。这些对话记录大多来自服务于Title I学校(面向低收入学区的资助对象)学生的高强度辅导项目,均在家长或监护人同意的情况下提供。个人身份信息先由提供机构进行了初步清除,随后Allen AI又通过数学专用处理流程进行了二次清除。
评估方式采用"回放(replay)"机制。将对话记录在关键判断时刻处暂停,由语言模型接手扮演辅导教师角色,与另一个扮演模拟学生的语言模型进行5轮对话。随后,基于大语言模型的评分流程会依据三项标准对每次回放进行评估:第一,在学生需要帮助时是否提供了支持(适当的支架式教学);第二,在学生已具备接受更多挑战的条件时是否提出了更高要求(适当的挑战性);第三,是否避免了在情境所需程度之上过度简化问题(避免过度支架式教学)。作为评分基准的正确标签由多名教师分别对各时刻进行标注,若意见不一致则以多数意见为准。
7个模型的初步实验结果
Allen AI在两种提示条件下,用TutorMoments对7个大语言模型进行了评估。一种是不附加任何指示、仅要求"好好辅导"的基础提示;另一种是明确说明支架式教学、过度支架式教学与挑战性之间权衡关系的"评估感知型"提示。所有分数均在0到1之间,表示模型在相应类型的时刻中做出恰当行为的比例。
人类教师的表现被作为一种自然参照值提出,而非理想标准。在同一判断时刻、采用相同评分方式的情况下,人类教师的适当支架式教学得分为0.458,适当挑战性得分为0.182,避免过度支架式教学得分为0.496。这些数值偏低的原因在于,该数据集有意集中收录了"本可以辅导得更好的时刻"。也就是说,收集的并非理想实践案例,而是被错过的教学机会。
最明显的规律是提示方式的影响。使用评估感知型提示时,所有模型的得分均高于基础提示时的得分。这说明模型默认的"乐于助人型助手"行为本身并不足以实现良好的辅导教学。但即便明确说明权衡关系,差距也未能完全缩小。要求更高挑战性的策略使用次数虽有所增加,但所使用的策略种类远少于人类,主动退后、让学生自行完成任务的行为也明显比人类教师少见得多。
公开范围与当前局限
配合此次预览,Allen AI公开了匿名化处理后的辅导对话数据集、回放处理流程代码,以及在所评估关键时刻上的模型辅导回放结果。技术报告可通过tutormoments.allen.ai获取,数据集发布于Hugging Face,代码发布于GitHub。
不过目前阶段仍存在若干限制。自动化评估虽能反映模型在判断时刻的行为倾向,但无法替代针对真实学生学习成效的研究。该数据集局限于美国范围、主要涵盖中小学数学科目,且标注者群体单一,因此结果难以推广到其他学科、年级或环境。挑战性评分的可靠性低于支架式教学评分,且在底层标注数据中,挑战性相关时刻(260个)的数量少于支架式教学相关时刻(738个)。
Allen AI表示,将通过此次预览收集反馈,并继续朝着构建更大规模的多模态数据集、强化评分流程、深化分析方向推进开发。该项目获得了盖茨基金会与Learning Commons的支持。


评论