


图片:METAL
摘要
- Sakana AI 于 10 月 9 日发布已被 TMLR 接收的论文《Beyond Imitation》。论文同时推出在 257 篇论文中植入 1164 处矛盾的基准,以及基于 Claude 的评审辅助系统 MLR。
- 在四份评审的条件下,MLR 发现了 73.43% 推翻核心主张的矛盾;但仅把 LLM-Review 的模型换成 Claude,其距离 0 的发现率就从 14.56% 升至 35.40%,差距的相当一部分来自模型。
- 在真实撤稿论文上,发现率降至 26.07%;每份评审成本约 0.5 美元,研究人员在 38 次会话中认同 81% 的评审意见。
Sakana AI 于 10 月 9 日发布论文《Beyond Imitation》,探讨 AI 如何协助论文评审人。论文提出一个衡量 AI 评审系统能在多大程度上发现论文内部矛盾的基准,同时推出 Sakana AI 设计的评审辅助系统"多层评审(MLR)"。MLR 发现了 73.43% 与论文核心主张正面冲突的矛盾,而用于比较的三个现有 AI 评审系统仅为 11% 至 15%。该论文已被机器学习期刊 TMLR 接收。
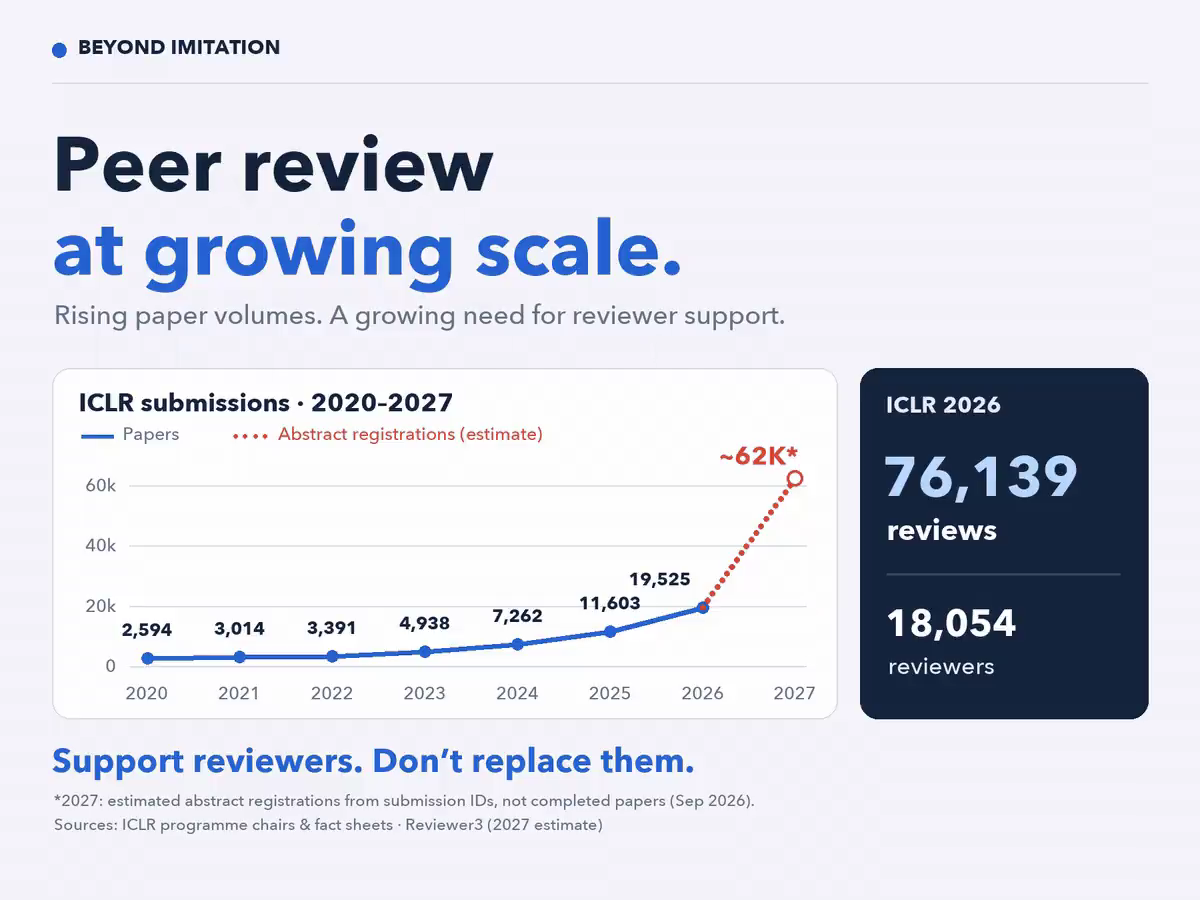
出发点是评审数量。根据 Sakana AI 随论文发布的图表,国际会议 ICLR 的投稿论文从 2020 年的 2594 篇增至 2026 年的 19525 篇,2027 年摘要注册量估计约为 62000 份。ICLR 2026 有 18054 名评审人撰写了 76139 份评审。Sakana AI 在 X 上表示"同行评审需要的是支持,而不是替代品",并称"AI 评审系统的开发和评估在很大程度上聚焦于它们模仿人类评审的相似程度"。论文标题"超越模仿"正源于此。
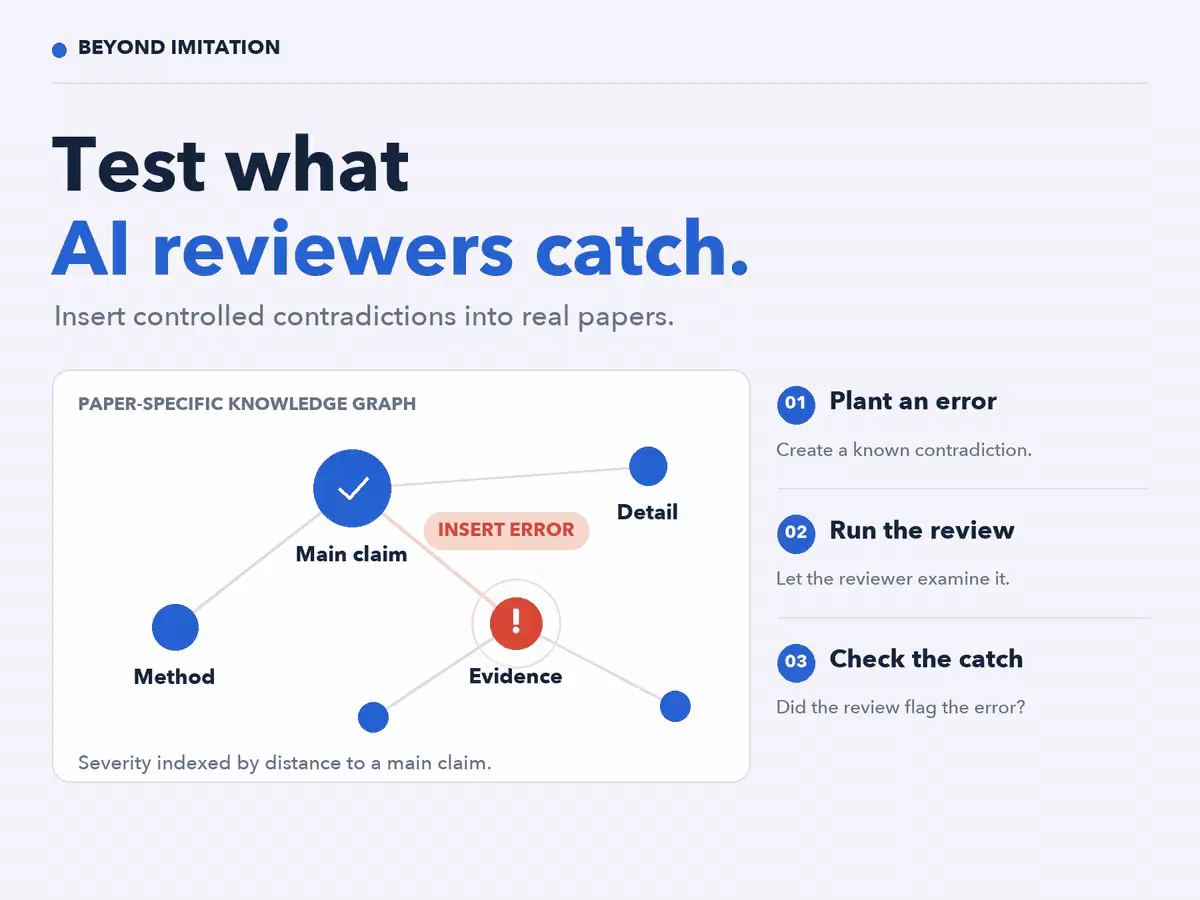
基准由刻意出错的论文构建。研究团队收集了 2025 年 ACL、AISTATS、CVPR、ICML 以及 2024 年 NeurIPS 上发表的 257 篇论文,只选用允许修改和再分发的知识共享许可论文。他们用 Gemini 2.5 Pro 为每篇论文绘制连接主张、证据、方法和实现的知识图谱,然后按与核心主张的距离各选一处,植入与原文冲突的句子。距离为 0 意味着核心主张本身被推翻,是最严重的错误。由此产生了 1164 处矛盾。评分由 OpenAI 的 o3 重复 10 次取平均:在没有错误的原始论文上正确回答"没有"的比例为 99.9%,对实际已被发现的矛盾确认"已发现"的比例为 86.8%。
MLR 由三个智能体运作。附录智能体(Claude Haiku 3.5)总结附录,文献综述智能体(Claude Sonnet 4)通过网络搜索整理已有研究。正文最多 10 页由评审智能体(Claude Sonnet 4)负责,并阅读三遍:第一遍形成概要,第二遍审视证据与弱点,第三遍综合前面的结果撰写评审。该设计借鉴了 Keshav 于 2007 年提出的分三遍阅读研究论文的方法。Sakana AI 解释说:"思路很简单:先理解论文,再作判断。"
结果在距离 0 处分出高下。在合并四份评审、只要其中一份指出错误即算成功的条件下,MLR 发现了 73.43% 的距离 0 矛盾,整体为 40.95%。比较对象中 LLM-Review 为 14.56%,AI Reviewer 为 11.17%,AgentReview 为 14.81%。即使只用一份评审,MLR 在距离 0 处仍达到 60.79%,整体为 28.32%。在所有系统中,矛盾离核心主张越远,发现率越低,研究团队表示这证明以知识图谱距离衡量的严重程度确实有效。
这一差距的相当一部分来自模型。三个比较系统都使用 OpenAI GPT 系列模型,只有 MLR 使用 Claude。研究团队仅把 LLM-Review 的模型换成 Claude Sonnet 4 后,其单份评审发现率整体从 6.39% 升至 16.43%,距离 0 处从 14.56% 升至 35.40%。把三遍阅读合并为单个提示词的 MLR 变体在 497 篇论文子集上也取得 24.81%,与原版单份评审的 28.32% 差别不大。研究团队在 OpenReview 回复中承认,三遍结构对错误发现和分数相关性都没有实质性影响。不过在距离 3 及以上、更难发现的错误上,差距有所拉大。负责评审的执行编辑 Quanming Yao 于 7 月 8 日建议"小修后接收",并评价称"该基准和以验证为中心的视角及时且有用"。
在真实撤稿论文上,数字有所下降。在收录因错误而撤回的 arXiv 论文的 WithdrarXiv-Check 上,MLR 指出与撤稿理由相似问题的比例为 26.07%,完全一致的比例为 16.11%。次优分别为 AgentReview 的 18.48% 和 AI Reviewer 的 9.00%。若只看撤稿理由中包含"证明"的论文,MLR 降至 15.2% 和 8.7%。在人工评审员的审核中,植入的 50 处矛盾里有 34% 被认为前后句衔接不自然,8% 被认为带有明显的 AI 写作痕迹。研究团队回应称:"由于矛盾是人为合成的,引入的错误比真实错误更容易发现,这是合理的。"他们同时给出解读:现有系统连这些较容易的错误也会漏掉。
研究团队还衡量了与人类评审的距离。在 ICLR 2025 论文上,由 MLR 评审预测的分数与人类实际评分的皮尔逊相关系数为 0.586,NeurIPS 2024 为 0.451,ICML 2025 为 0.429。在 ICML 上,AI Reviewer 以 0.439 略微领先。不过评审关注的重点与人类不同。人类评审人常指出写作清晰度和新颖性,而 MLR 更看重有效性;其与人类评审的关注分布差异(KL 散度平均值)为 0.240,在比较对象中仅次于 AI Reviewer 的 0.266。
系统还接受了攻击测试。研究团队在 50 篇被拒论文(大多曾投稿 ICLR 2025)的结论之后插入了旨在左右 AI 评审人判断的隐藏文字。所有系统都受到这段文字的严重影响,MLR 在 50 例中的 8 例里察觉到操纵文字的存在。每份评审成本约为 0.5 美元。MLR 的输入 token 为 189062 个,约为 AI Reviewer 403654 个的一半。研究团队估计论文全部实验的 API 成本约为 3500 美元。
真实研究人员对弱点部分最为苛刻。在研究人员上传自己的稿件、使用完整 MLR 系统的 38 次会话中,378 条评审意见里有 305 条(81%)获得认同。总体建议为 94%,优点为 92%,而弱点最低,为 68%。批评强度评分为满分 5 分中的 2.88,接近中性;同时出现了批评越尖锐、有用性评分越低的弱负相关(r=-0.29)。
根据 METAL 核实的 58 页论文原文和 OpenReview 评审记录,作者是 Sakana AI 的 Rachel Teo、Yutaro Yamada、Shashank Kotyan、Yuki Imajuku 和 Tarin Clanuwat 五位研究员。论文于 10 月 8 日发布在 arXiv 上,三位评审人都要求作者区分模型与设计的效果,相关结果被放入正文图表。METAL 此前曾报道 Sakana AI 发布无需反向传播的学习方法 PC-ALM,以及聘请 Jürgen Schmidhuber 担任首席科学顾问的消息。
从工程师的角度看,这篇论文留下的更多是基准而非 MLR。发现率的提升有相当一部分来自更换模型,三遍结构的效果仅限于困难错误。相比之下,用知识图谱衡量错误分量并植入错误的流程,可以随着新的会议论文不断扩展。Sakana AI 表示,其目标是"在以人类专业知识和判断为核心的前提下,帮助评审人核查研究"。
评论