


图片:METAL
摘要
- 谷歌DeepMind于10月6日以Apache 2.0许可证发布开放模型EmbeddingGemma 2,可将文本、代码、图像、音频和视频映射到同一个嵌入空间。
- 模型共有7.4亿参数,由2.7亿参数的文本核心加上可选的视觉与音频编码器组成,在Pixel 11 Pro上仅文本约占用191MB内存,完整多模态约567MB。
- 其MTEB Code得分从68.76升至78.68,上下文窗口为8192个token,是第一代的四倍,向量可截断至128维,存储最多可减少六倍。
谷歌DeepMind于10月6日发布开放模型EmbeddingGemma 2,可将文本、代码、图像、音频和视频放入同一个嵌入空间。模型参数为7.4亿,专为在智能手机、笔记本电脑等个人设备上运行而设计。谷歌称其为设备端多模态嵌入领域能力最强的模型。模型以允许商业使用的Apache 2.0许可证发布,权重可在Hugging Face和Kaggle下载。
嵌入模型会把文字、照片或声音转换成由数字组成的向量,让含义相近的内容彼此靠近。它是搜索、推荐和检索增强生成(RAG)的底层组件。去年9月推出的第一代EmbeddingGemma只能处理文本。撰写发布文章的谷歌DeepMind研究工程师Sahil Dua和Henrique Schechter Vera表示,第一代模型下载量已超过2000万次,并称“开发者社区的反响远远超出了我们的预期”。开发者用它搭建了设备端搜索工具,以及不把个人数据外传的RAG流程。
第二代的核心是把多种感官统一起来。两位工程师解释说,这个模型“可以通过一段语音备忘录找到特定的视频片段,或用一句文本查询检索数小时的录音,而这一切都由单一的原生多模态模型完成”。它基于今年4月发布的Gemma 4架构。谷歌表示,该模型与Gemini Embedding模型采用了相同的技术。
模型采用模块化设计。只处理文本和代码时仅需2.7亿参数,1.7亿参数的视觉编码器和3亿参数的音频编码器只在需要时加载。据报道,模型卡列出文本加视觉组合为4.4亿参数、文本加音频组合为5.7亿参数,无论哪种组合都共用同一个768维向量空间。只搜索照片的应用无需把音频编码器载入内存。
内存数据也很具体。谷歌表示,经量化后在Pixel 11 Pro上运行时,仅文本权重约占191MB活动内存,完整多模态模型约占567MB。上下文窗口为8192个token,是第一代的四倍。单次输入可容纳5.5分钟音频、29张图像、58个视频帧,或它们的混合。据报道,一张图像占用280个token,一个视频帧占140个token,一秒音频占25个token。
模型还加入了节省存储的机制。借助套娃表示学习(MRL),开发者可以把768维输出向量截断为512、256或128维,谷歌称这能让本地向量数据库的存储和内存占用最多减少六倍。据报道,谷歌开发者指南指出,在256维时图像、视频和语音检索可保留约95%的完整质量;在128维时文本和代码可保留约90%,但多模态检索会降至约75%。
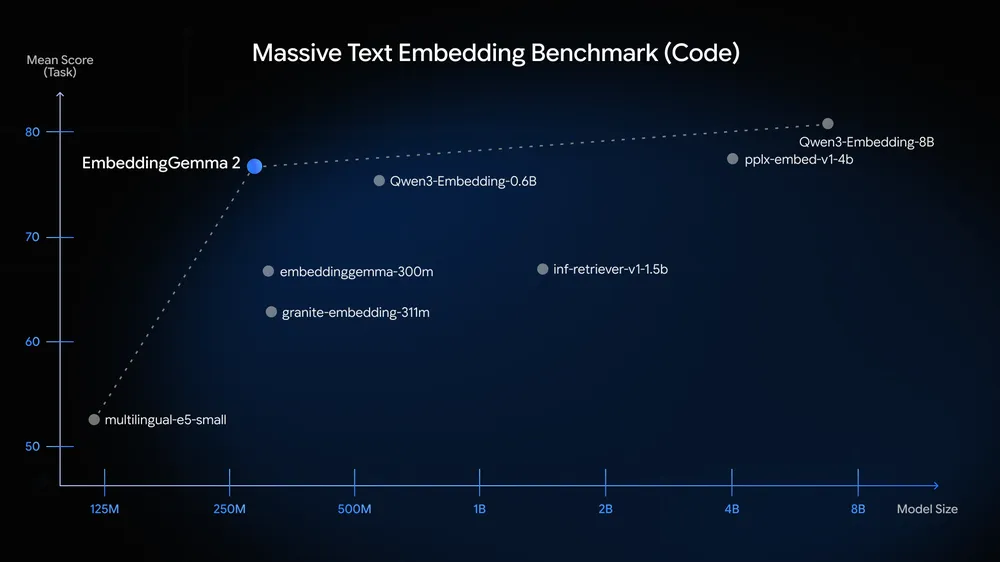
成绩单上提升最大的是代码。大规模文本嵌入基准(MTEB)代码部分的得分从68.76升至78.68,提高9.92分,多语言文本性能则维持在第一代水平。在METAL查阅的谷歌发布文章中的MTEB代码图表里,EmbeddingGemma 2的位置高于6亿参数的Qwen3-Embedding-0.6B,与80亿参数的Qwen3-Embedding-8B相差几分。谷歌表示,它在10亿参数以下的多模态嵌入模型中取得最高分,并在图像、视频和音频任务上超过了部分规模是其两倍以上的专用模型。
从工程角度看,值得关注的是它与Gemma 4共用组件。EmbeddingGemma 2共享Gemma 4的文本分词器和音频编码器,因此两个模型在同一流程中运行时总内存占用会下降。负责检索的模型和负责回答的模型在同一台设备上使用相同的部件。谷歌在AI Edge Gallery应用中加入了Video Moments Finder演示,可通过文字或语音找到视频中的场景。Mac会议应用AI Edge Foresight用这个模型查找本地文件,再用Gemma 4进行上下文推理。
部署途径也很广。模型可在Transformers、Sentence Transformers、MLX、vLLM、llama.cpp、SGLang、Ollama和LM Studio上运行,微调可参照Unsloth的指南。设备端支持MediaPipe和LiteRT,浏览器端支持transformers.js和WebGPU。谷歌表示,模型很快将上线Gemini Enterprise Agent Platform的Model Garden。据报道,模型卡提示其激活值范围超出float16,可能产生NaN,建议使用bfloat16或float32推理,训练数据截止时间为2025年1月。
METAL曾报道Liquid AI开源了设备端模型评估工具Pipette。设备端竞争正从生成模型下沉到检索组件。无需把照片和录音上传服务器,就能在设备内找到视频中的某个场景,这件事如今用一个内存占用不到600MB的组件就能做到。应用开发者现在需要决定的,是加载哪些编码器,以及把向量压缩到多少维。
信息来源
- Google — EmbeddingGemma 2 is a best-in-class open model for natively multimodal embeddings →
- Google DeepMind — EmbeddingGemma 2: an open, lightweight multimodal embedding model →
- Unite.AI — DeepMind Debuts EmbeddingGemma 2, Mapping Five Modalities Into One Space →
- AlphaSignal — Google DeepMind's EmbeddingGemma 2 Searches Audio, Video, and Images on Your Phone →
- SiliconANGLE — Google expands EmbeddingGemma beyond text to images, audio and video →
评论